
Investigadores desarrollan un nuevo modelo de entrenamiento para prótesis de extremidades
Investigadores de la Universidad Tecnológica de Shenyang y de la Universidad de Electrocomunicaciones de Tokio intentan averiguar cómo lograr que las prótesis de brazo reaccionen a los movimientos de la mano.
Durante la última década, los científicos han intentado averiguar cómo usar las señales de electromiografía de superficie (EMG) para controlar las prótesis de extremidades. Las señales EMG son las señales eléctricas que hacen que nuestros músculos se contraigan. Se pueden registrar insertando agujas de electrodos en el músculo. Las EMG de superficie se registran con electrodos colocados sobre la piel, encima de los músculos.
En la última década, los investigadores han empezado a estudiar el posible uso de las señales EMG de superficie para controlar prótesis en personas con amputaciones de extremidades, especialmente en lo que respecta a la complejidad de los movimientos y gestos necesarios en las prótesis de brazo, para lograr que los dispositivos sean más fluidos, más receptivos y más intuitivos de lo que es posible actualmente.
Las EMG de superficie sí pueden usarse para que las prótesis de extremidades reaccionen más rápido y se muevan de forma más natural. Sin embargo, las interrupciones, como el desplazamiento de los electrodos, pueden dificultar que el dispositivo reconozca estas señales. Una forma de superar esto es entrenar las señales EMG de superficie. El entrenamiento puede ser un proceso largo y, a veces, difícil para las personas con amputaciones de extremidades.
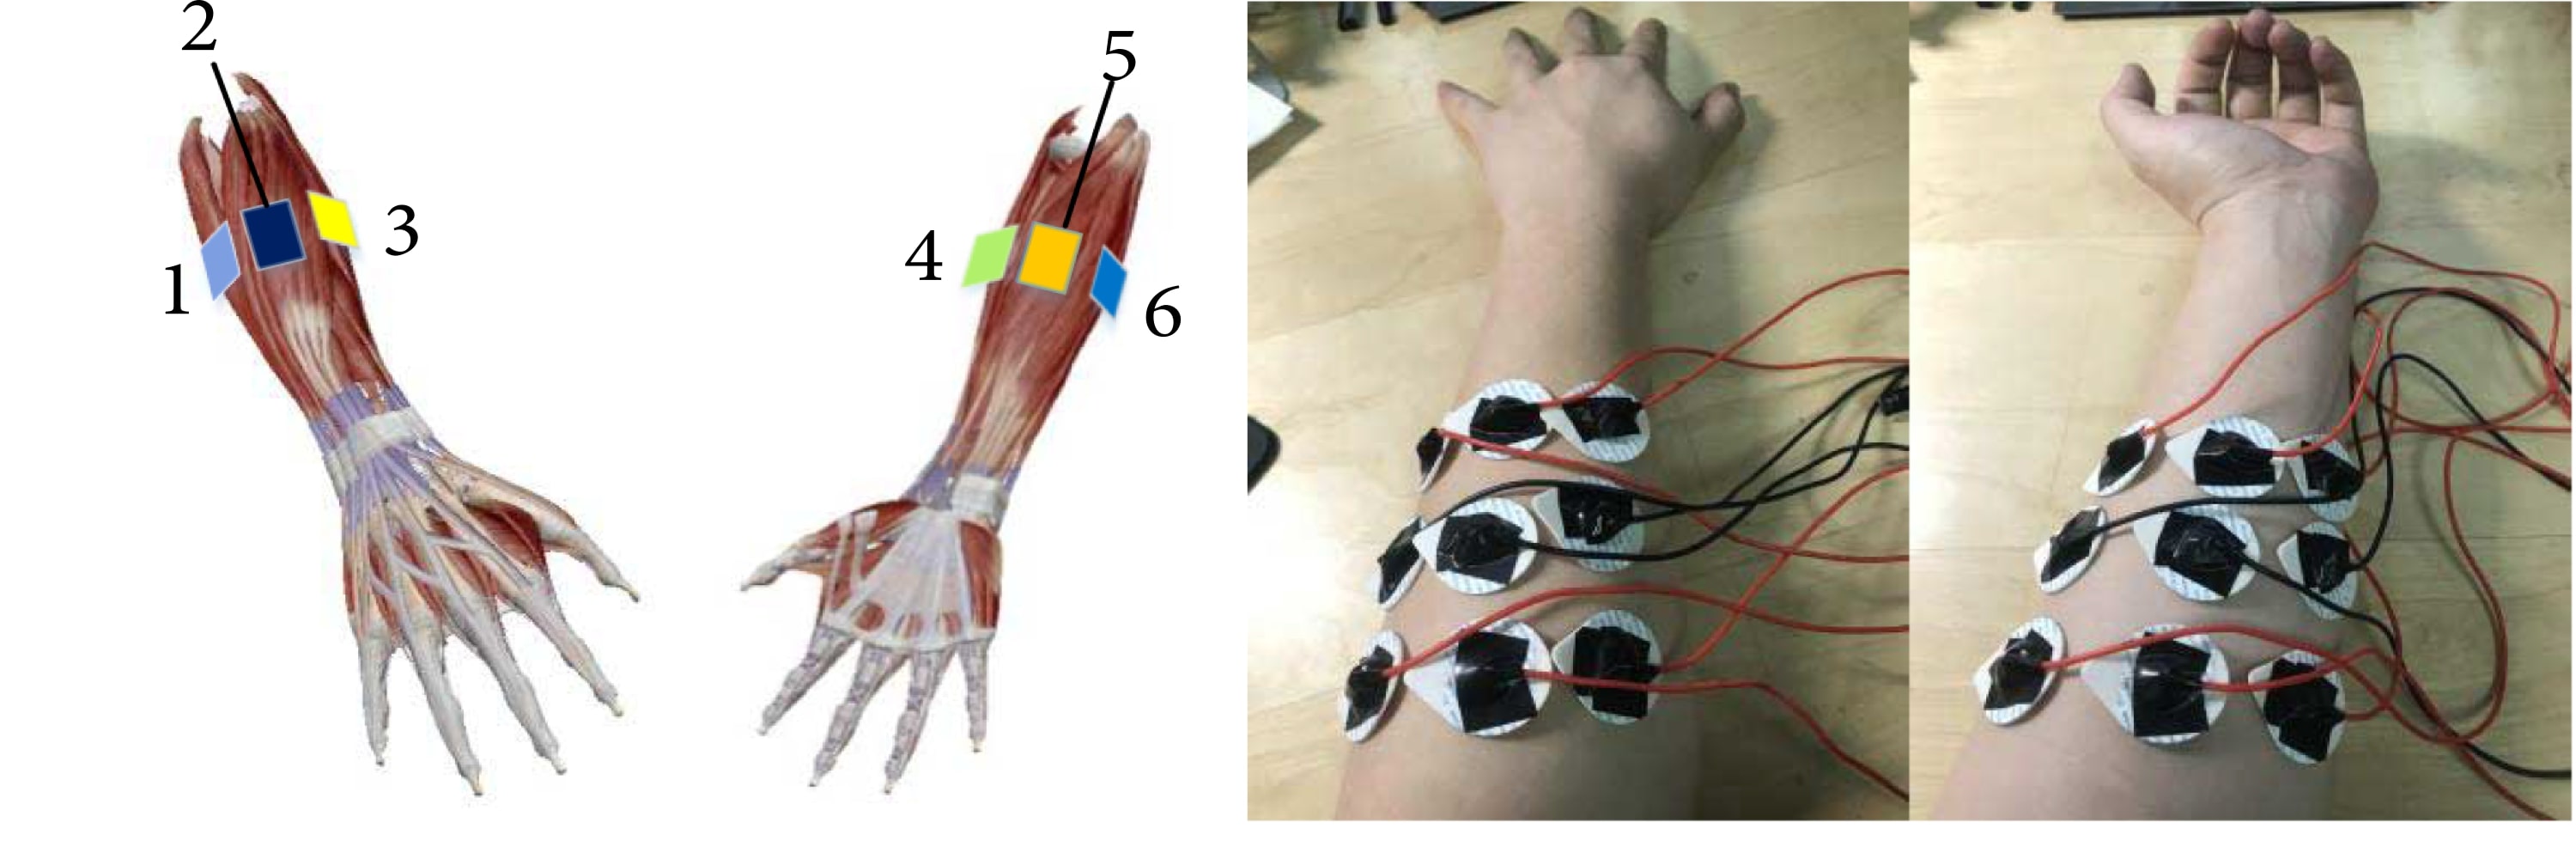
Por eso, muchos investigadores han recurrido al aprendizaje automático. Con el aprendizaje automático, una prótesis puede aprender a distinguir los movimientos musculares que indican gestos y los movimientos de los electrodos.
Los autores del estudio, publicado en la revista Cyborg and Bionic Systems, desarrollaron un método único de aprendizaje automático que combina una red neuronal convolucional (CNN) y una red neuronal de memoria a largo plazo (LSTM). Se decantaron por estos dos métodos por sus ventajas complementarias.
«El aprendizaje profundo para el reconocimiento de gestos basado en la electromiografía de superficie desempeña un papel cada vez más importante en la interacción entre personas y ordenadores. Para garantizar una alta precisión del aprendizaje profundo en el reconocimiento de movimientos musculares con múltiples estados, y para asegurar que el modelo de aprendizaje pueda aplicarse en un chip integrado con poca memoria, este artículo presenta un método para construir y optimizar un modelo funcional basado en un bloque de amplificación multicanal de sEMG», afirma el estudio.
La CNN capta bien las dimensiones espaciales de las señales EMG de superficie y entiende cómo se relacionan con los gestos de la mano. Sin embargo, tiene problemas con el tiempo. Los gestos se producen a lo largo del tiempo, pero la CNN ignora la información temporal en las contracciones musculares continuas. Normalmente, las CNN se utilizan para el reconocimiento de imágenes.
La LSTM se suele utilizar para el reconocimiento de escritura a mano y del habla. Esta red neuronal procesa, clasifica y hace predicciones muy bien a partir de secuencias de datos a lo largo del tiempo. El problema aquí es que, aunque los investigadores han logrado una mejor clasificación de los gestos de las señales sEMG, el tamaño del modelo computacional necesario es un problema serio.
El microprocesador que hay que utilizar es limitado. Usar algo más potente sería demasiado caro. Y, por último, aunque estos modelos de aprendizaje profundo funcionan con ordenadores en el laboratorio, son difíciles de aplicar con el hardware integrado que se encuentra en un dispositivo protésico.
«Al fin y al cabo, las redes neuronales convolucionales se concibieron para el reconocimiento de imágenes, no para controlar prótesis. Necesitábamos combinar la CNN con una técnica que pudiera tratar la dimensión temporal, y también hacer posible un dispositivo físico que el usuario debe llevar puesto»
El equipo de investigación creó un modelo híbrido que combina la conciencia espacial de la CNN con la conciencia temporal de la LSTM. Al final, redujeron el tamaño del modelo de aprendizaje profundo, manteniendo al mismo tiempo una alta precisión y una gran robustez frente a las interferencias.
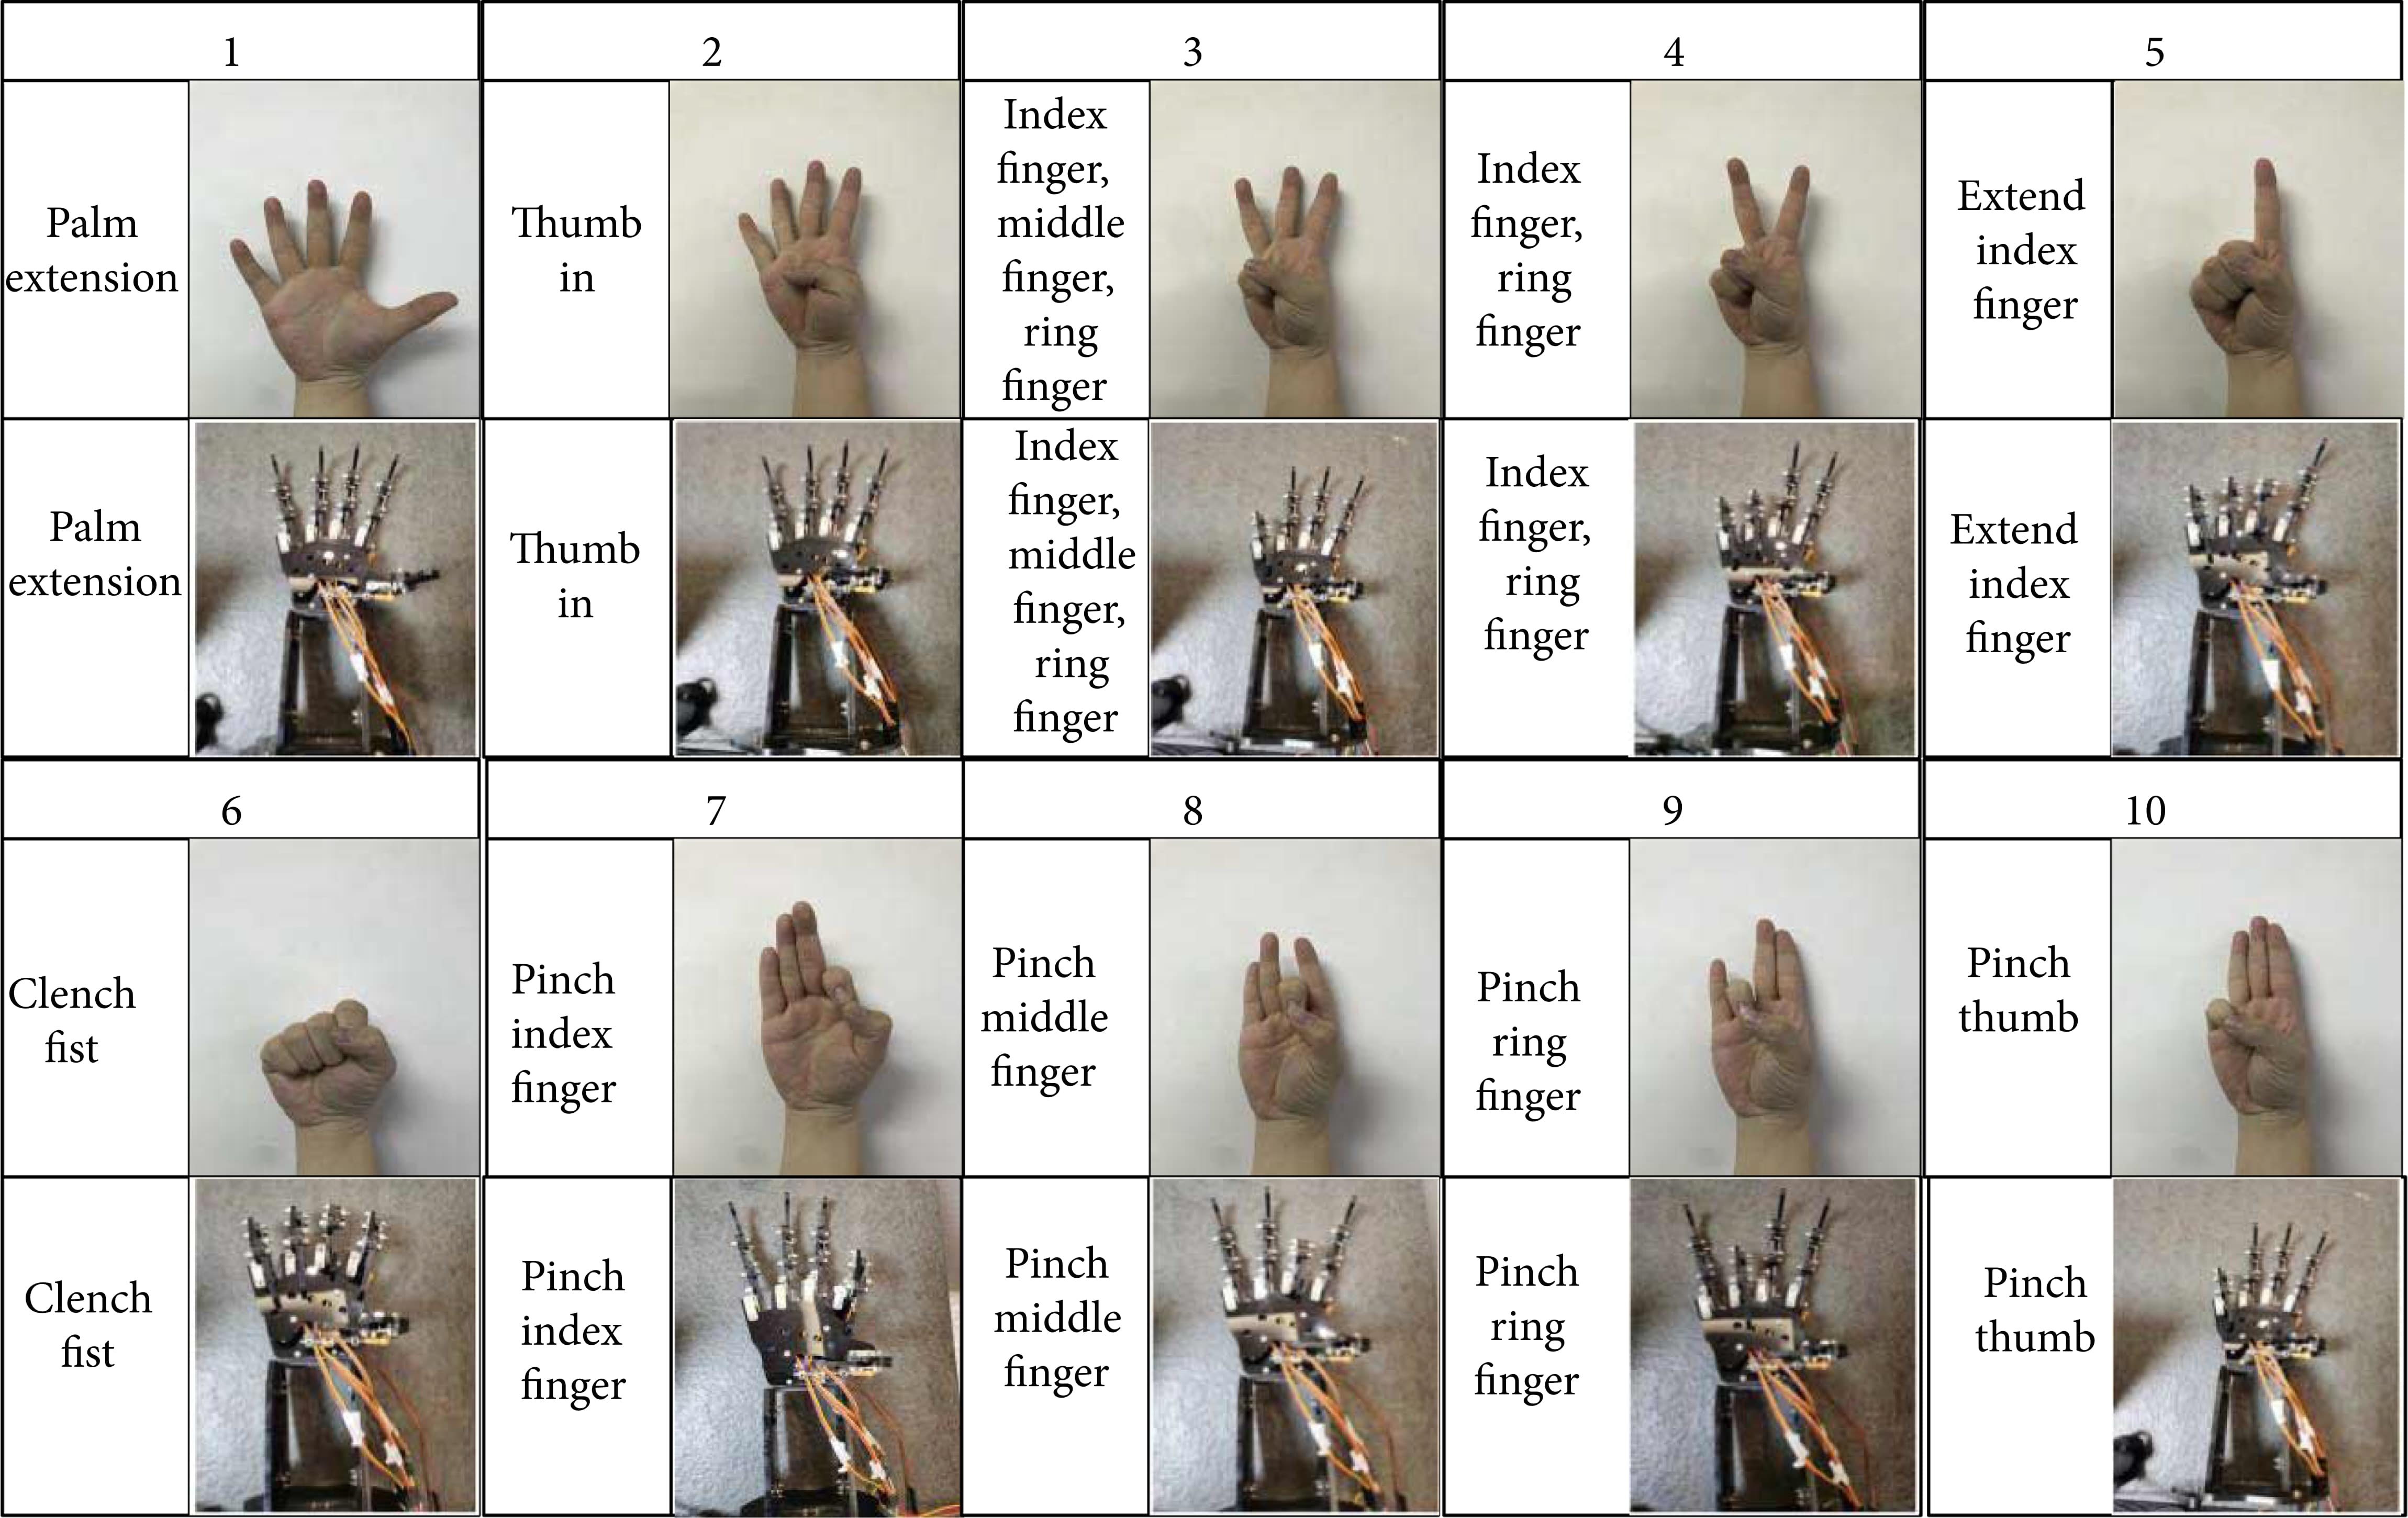
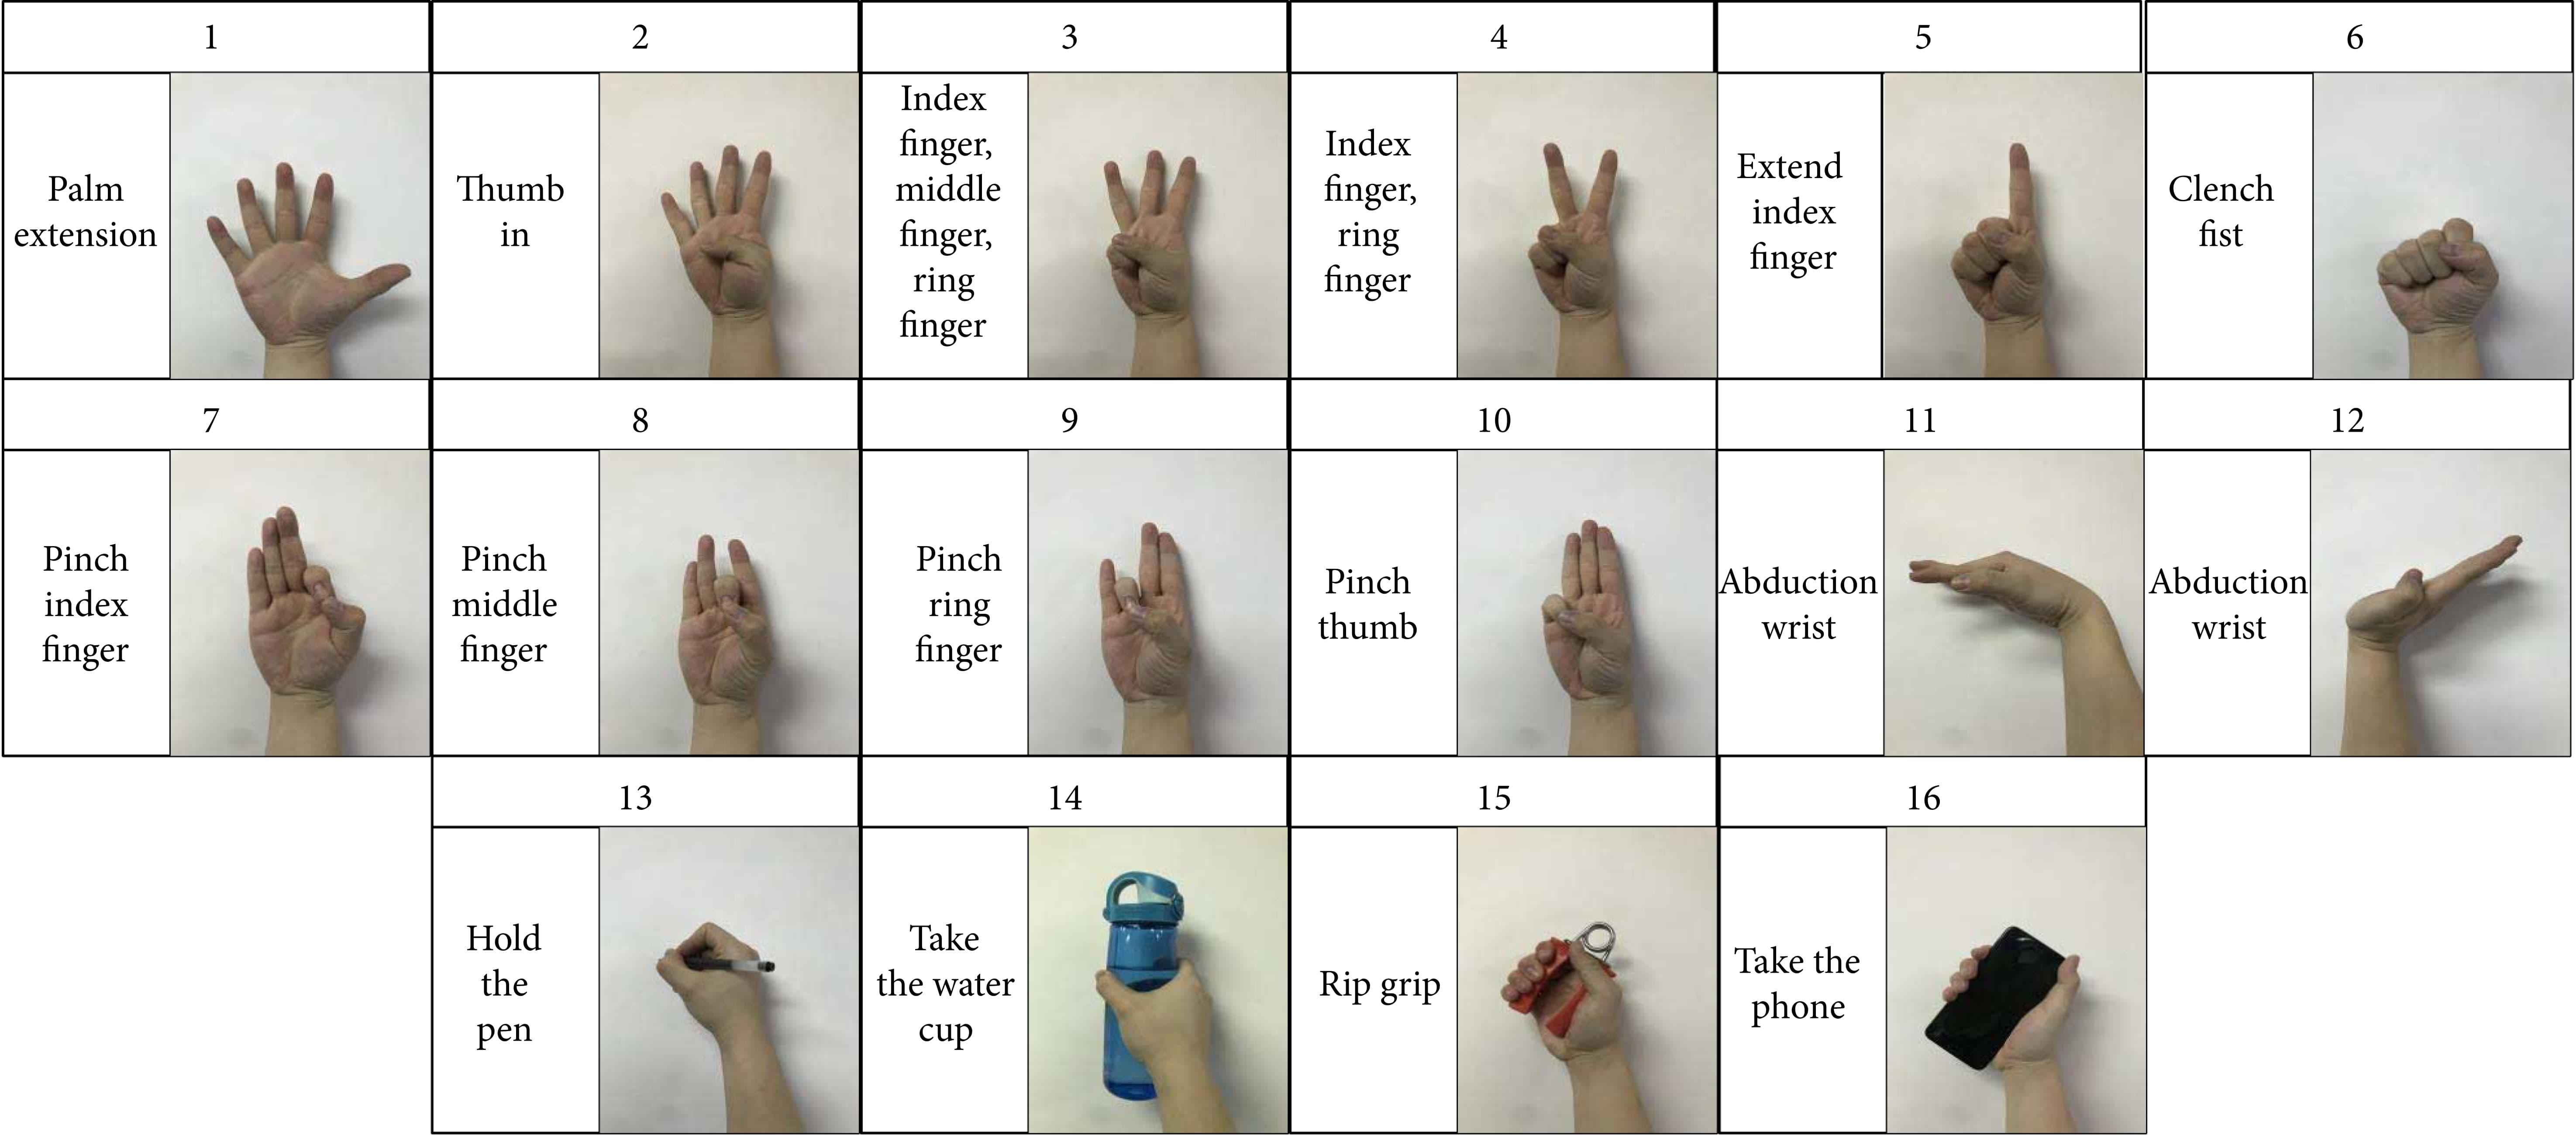
El sistema se probó con diez sujetos sin amputaciones de extremidades, con una serie de 16 gestos de mano diferentes. Tuvo una precisión de reconocimiento superior al 80%. El sistema se desenvolvió bien con la mayoría de los gestos, como agarrar un teléfono, un bolígrafo, señalar, pellizcar y sujetar una taza con agua. Sin embargo, el enfoque híbrido no logró reconocer con precisión dos gestos de pellizco: el que usa el dedo medio y el que usa el dedo índice.
En general, según el equipo, los resultados superaron a los métodos de entrenamiento tradicionales. En trabajos futuros, los investigadores quieren optimizar el algoritmo y aumentar aún más su precisión, manteniendo al mismo tiempo un modelo de entrenamiento pequeño para que pueda utilizarse en el hardware de las prótesis. También quieren averiguar qué causa las dificultades para reconocer los gestos de pellizco y ampliar sus experimentos a un número mucho mayor de sujetos.
En última instancia, los investigadores quieren desarrollar una prótesis de brazo tan flexible y fiable como la extremidad original del usuario.


