
Meta研究人员打造同样擅长视觉、文本和语音学习的AI
自监督学习——即机器不是通过标注图像、文本、音频及其他数据源进行显式训练,而是直接观察周围环境进行学习——已成为近期AI诸多重大突破的基础。
但是,尽管人类似乎无论通过何种方式获取信息(例如依靠视觉还是听觉)都以相同方式学习,目前自监督学习算法在如何从图像、语音、文本及其他数据中学习方面仍存在很大差异。
这种不一致一直是推广自监督学习进展的重大障碍。由于为例如图像理解而开发的强大算法无法直接应用于另一模态(例如文本),因此很难让多种模态以相同速度向前推进。
正因如此,Meta AI 开发了 data2vec——首个适用于多种模态的高性能自监督算法。Data2vec分别应用于语音、图像和文本,它超越了此前计算机视觉和语音领域的最佳单任务算法,并且在NLP(自然语言处理)任务中也具有竞争力。
这代表了一种整体自监督学习的新范式,新研究能够同时改进多种模态,而不只是一种。它也不依赖对比学习或对输入样本的重构。
Data2vec不仅有助于加快人工智能领域的进展,还让我们更接近能够无缝学习周围世界各个方面的机器。研究人员认为,这将带来适应性更强的AI,能够完成现有系统范围之外的任务。
data2vec的工作原理
目前大部分AI仍基于仅处理标注数据的监督学习。但我们希望机器完成的所有事情,根本不可能都收集到标注数据。例如,尽管研究人员在英语语音和文本的大规模标注数据集方面做了大量工作,但对于地球上数以千计的语言来说,这根本无法实现。
自监督让计算机仅通过观察世界,然后找出图像、语音或文本的结构来认识世界。拥有无需明确训练即可对图像分类或理解口语的机器,其可扩展性要高得多。
如今自监督学习研究几乎总是聚焦于某一特定模态。因此,专注于一种模态的研究人员,往往采用与专注于另一种模态的研究人员完全不同的方法。以文本为例,研究人员训练模型填补句子中的空白。

然而,语音模型必须学习一组基本语音单元,以预测缺失的声音。在计算机视觉中,模型通常被训练为:将彩色的奶牛图像与其上下颠倒的同一图像赋予相似的表示,使其比与无关图像(如鸭子图像)联系得更紧密。
算法还为每种模态预测不同的单位:图像为像素或视觉标记,文本为词语,语音为习得的声音集合。像素集合与声波或一段文本有很大不同,因此算法开发被绑定于特定模态。这意味着算法在每种模态中仍以不同方式运行。
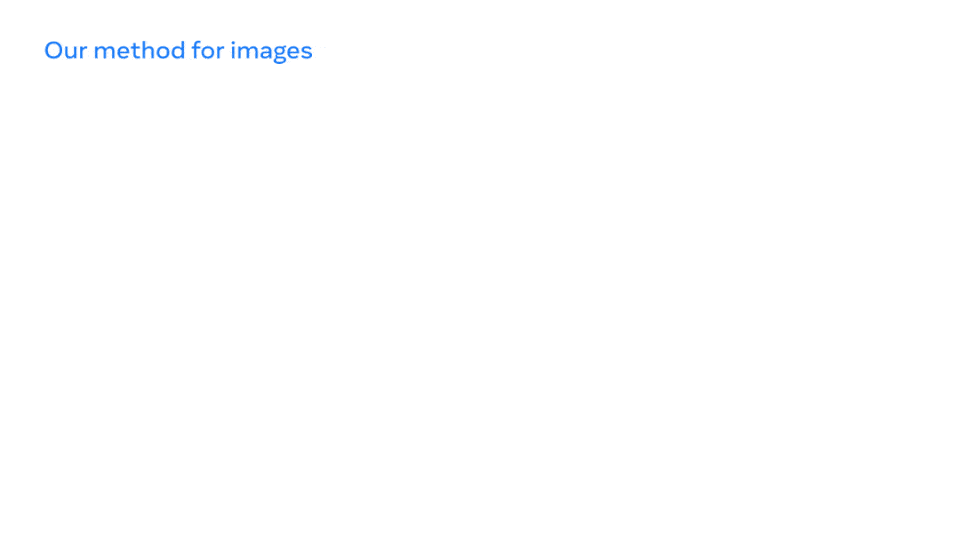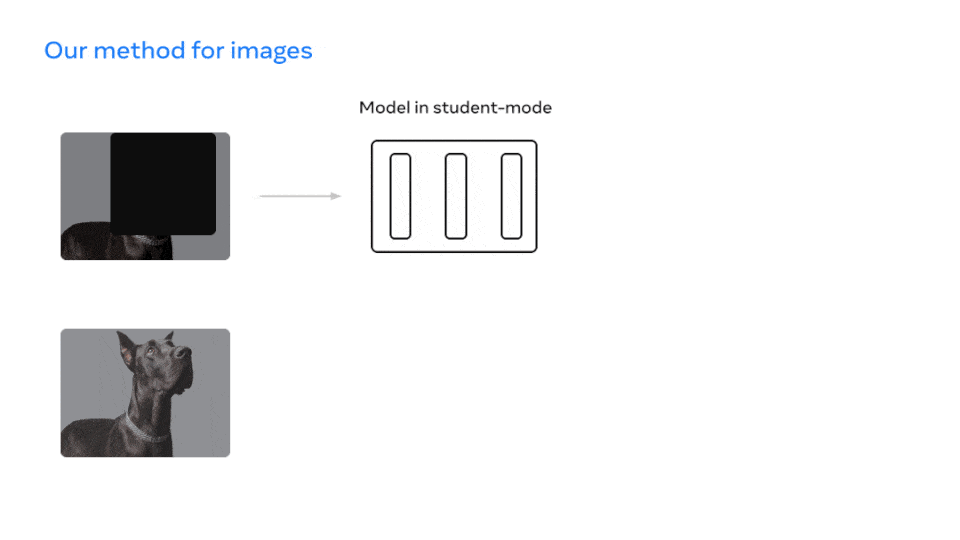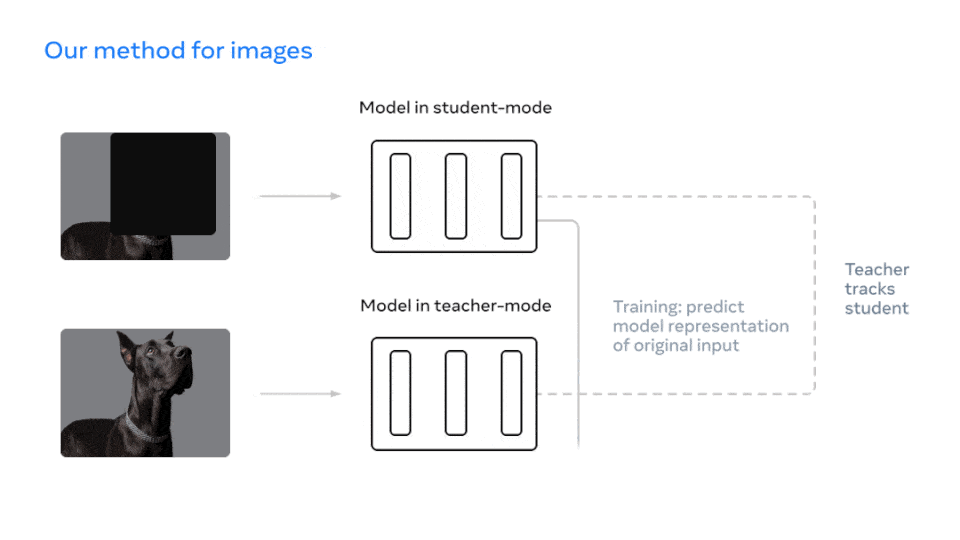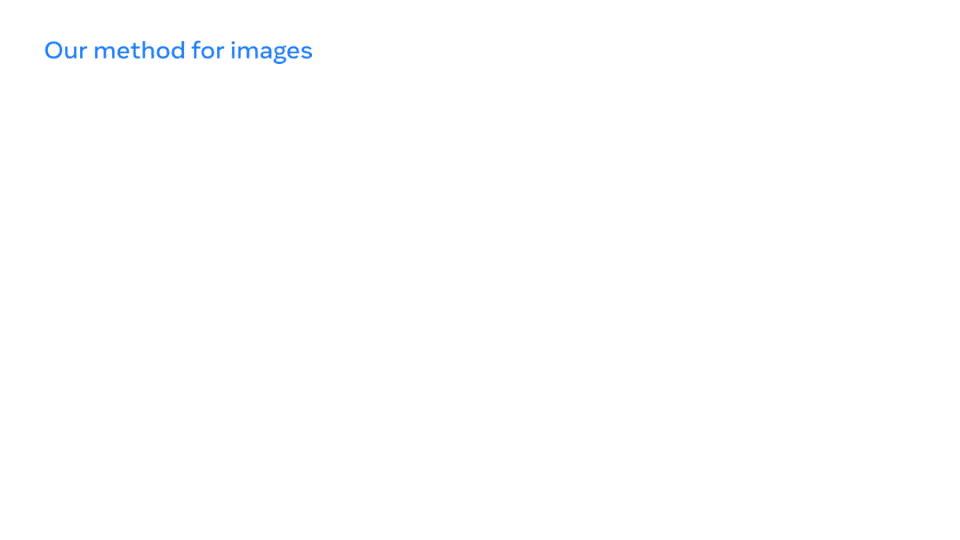
Data2vec通过训练模型预测其自身对输入数据的表示来简化这一点,与模态无关。它专注于这些表示——神经网络的各层——而不是预测视觉符号、词语或声音,因此同一个算法可以处理截然不同类型的输入数据。
Meta研究人员的方法使用一个教师网络,先从图像、文本片段或语音语句中计算出目标表示。然后遮蔽部分输入数据,并用学生网络重复该过程,学生网络则预测教师网络的隐藏表示。学生模型必须预测所有输入数据的表示,即使它只掌握部分信息。
科学家在流行的计算机视觉基准测试ImageNet上测试了该方法,对于常见的模型规模,它的表现优于现有方法。在语音方面,他们发现它比wav2vec 2.0或HuBERT(Meta AI此前用于语音的两种自监督算法)表现更好。在文本方面,他们在流行的GLUE测试集上测试,结果与RoBERTa(BERT的重新实现)持平。

虽然自监督学习通过各种训练目标在计算机视觉、视频及其他单一模态领域取得了巨大成功,但这一方法的核心思想在于更通用的学习:人工智能应当能够学习执行多种不同的任务,包括完全陌生的任务。
研究人员希望机器不仅能识别训练数据中展示的动物,还能在被告知新生物的外观后,学会识别这些新生物。Data2vec 表明,同一种自监督算法可以在不同模态中表现出色,而且往往优于现有的最佳算法。
这为更通用的自监督学习铺平了道路,让我们离这样一个世界更近了一步:人工智能能够借助视频、文章和音频记录学习复杂的事情,例如踢足球或各种烤面包的方法。该公司希望,data2vec 能让我们所有人更接近这样一个世界:计算机完成任务时只需要极少的标注数据。
由于收集带标注的样本既困难,有时甚至不可能——例如,为数千种语言训练语音识别模型——data2vec 是迈向更通用人工智能的重要一步。
“人类通过视觉、声音和文字的结合来认识世界,而这类系统有朝一日也能像我们一样理解世界”
这仍处于早期研究阶段,所以不要指望传说中的“通用人工智能”会突然出现。但拥有一种通用学习架构、能够适用于不同领域和数据类型的人工智能,似乎比我们今天所依赖的那一堆零散的“微型智能”更好、更优雅。


