
Meta AI研究者、視覚・テキスト・音声を同じ精度で学習するAIを開発
自己教師あり学習とは、画像、テキスト、音声などのラベル付きデータで明示的に教えるのではなく、機械が環境を直接観察して学ぶ手法であり、近年のAIにおける多くの大きな進歩の基盤となっています。
人間は視覚や聴覚など、情報の受け取り方に関係なく同じように学習しているようです。しかし現在、自己教師あり学習のアルゴリズムは、画像、音声、テキストなどのデータからの学習方法に大きな違いがあります。
この不一致は、自己教師あり学習の進歩をより広く応用する上で大きな障害となってきました。例えば画像の理解に開発された強力なアルゴリズムを、テキストなど別のモダリティにそのまま適用することはできないため、複数のモダリティを同じスピードで発展させることは困難です。
こうした背景から、Meta AIはdata2vecを開発しました。これは複数のモダリティで機能する初の高性能な自己教師ありアルゴリズムです。data2vecは音声、画像、テキストそれぞれに個別に適用され、コンピュータビジョンと音声では従来の単一目的のアルゴリズムを上回り、自然言語処理(NLP)のタスクでも競争力のある性能を示しました。
これは、一つのモダリティだけでなく複数のモダリティを改善する新たな研究が進む、統合的な自己教師あり学習の新しいパラダイムです。また、対照学習や入力例の再構成に依存していません。
data2vecはAI分野の進歩を加速させるだけでなく、機械が世界のさまざまな側面をシームレスに学習できるシステムの実現にも近づけます。研究者によれば、これはより適応性の高いAIの開発につながり、現在のシステムの能力を超えるタスクもこなせるようになると考えられています。
data2vecの仕組み
現在のAIの多くは、ラベル付きデータのみを用いる教師あり学習に依存しています。しかし、機械にさせたいすべての事柄についてラベル付きデータを集めることは不可能です。例えば、研究者たちは英語の音声やテキストについては大規模なラベル付きデータセットを作成してきましたが、地球上で話されている文字通り数千の言語については、それを行うことはできません。
自己教師あり学習では、コンピュータは世界を観察するだけで、画像、音声、テキストの構造を見つけ出しながら世界について学びます。画像の分類や話し言葉の理解を明示的に教える必要がない機械は、はるかに拡張性が高いのです。
今日の自己教師あり学習の研究は、ほぼ常に一つの特定のモダリティに焦点を当てています。そのため、あるモダリティに取り組む研究者は、別のモダリティに取り組む研究者とはまったく異なるアプローチを用いることがよくあります。テキストの場合、研究者はモデルに文中の空欄を埋めるよう学習させます。

一方、音声モデルは欠落した音を予測するために、音声の基本的な音の一覧を学習しなければなりません。コンピュータビジョンでは、モデルはカラーの牛の画像と、それを上下逆さまにした同じ画像に類似の表現を割り当てるよう学習することが多く、そのため無関係な画像(例えばアヒルの画像)よりもはるかに強く両者を結び付けます。
アルゴリズムはモダリティごとに異なる単位も予測します。画像ではピクセルや視覚トークン、テキストでは単語、音声では学習された音のセットです。ピクセルの集合は音声波形やテキストの一節とは大きく異なるため、アルゴリズムの設計は特定のモダリティに縛られてしまいます。つまり、アルゴリズムは各モダリティで依然として異なる動作をしています。
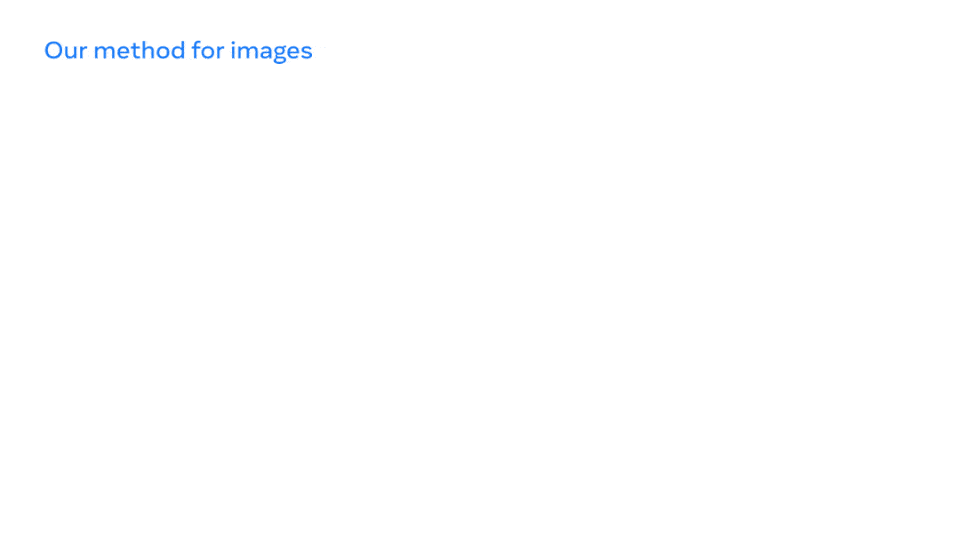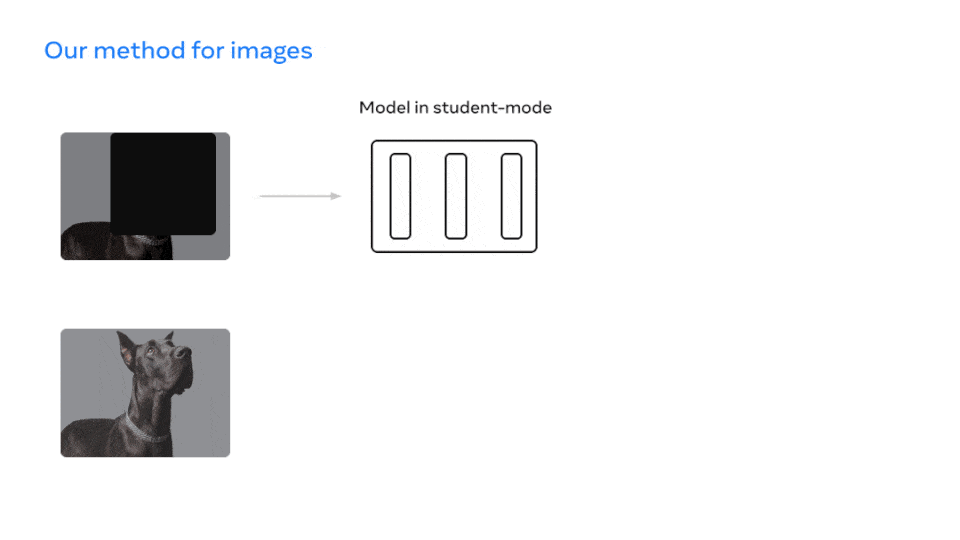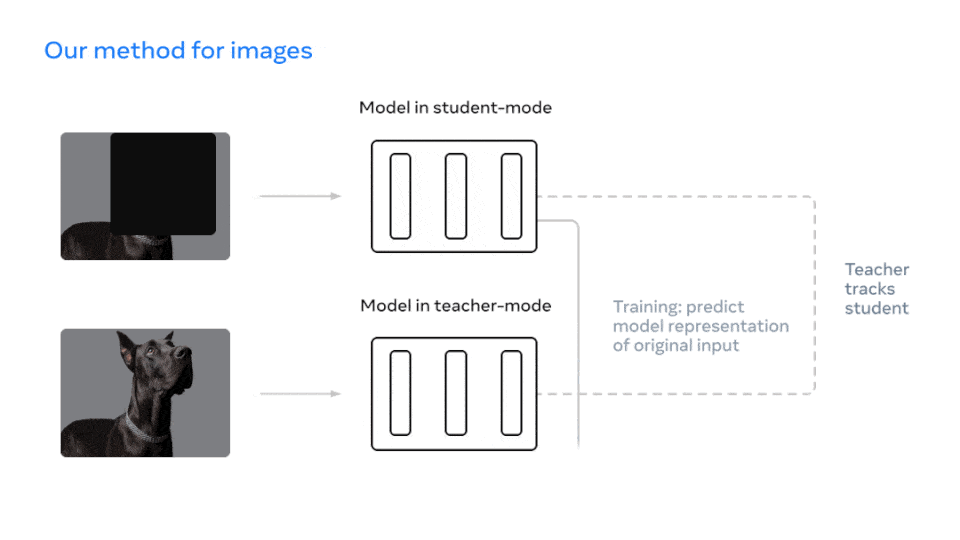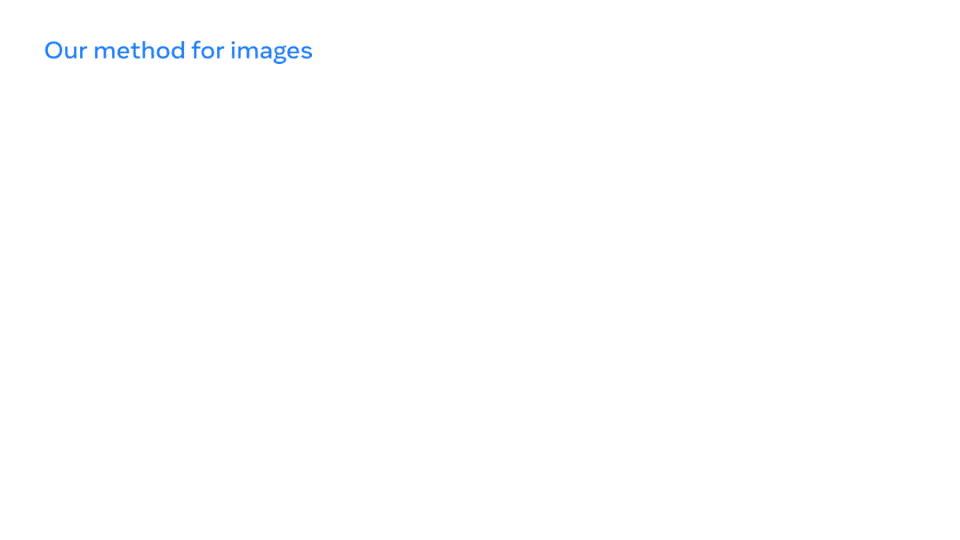
data2vecは、モダリティに関係なく、入力データの自身の表現を予測するようモデルを学習させることで、この問題を単純化します。視覚記号、単語、音の予測ではなく、ニューラルネットワークの層である表現に焦点を当てることで、一つのアルゴリズムが非常に異なる種類の入力データを扱えるようになります。
Meta の研究者の手法では、まず教師ネットワークを使い、画像、テキストの断片、または音声の発話からターゲットとなる表現を計算します。次に入力データの一部をマスクし、生徒ネットワークで同じプロセスを繰り返します。生徒ネットワークは教師の隠れた表現を予測します。生徒モデルは、情報の一部しか持っていなくても、すべての入力データの表現を予測しなければなりません。
研究者らは、この手法を人気のあるコンピュータビジョンのベンチマークであるImageNetでテストしたところ、一般的なモデルサイズにおいて既存の手法より優れた結果を示しました。音声については、Meta AIの以前の自己教師あり音声アルゴリズムであるwav2vec 2.0およびHuBERTよりも高い性能を示すことがわかりました。テキストについては、人気のベンチマークであるGLUEでテストし、BERTを再実装したRoBERTaと同等の結果を示しました。

自己教師あり学習は、コンピュータビジョン、動画、その他の個別のモダリティにおいて、さまざまな学習目標を用いて大きな成功を収めてきましたが、このアプローチの根本的な考え方は、より汎用的な学習にあります。AIは、まったく未知のタスクを含め、多種多様なタスクを学習できなければなりません。
研究者が目指しているのは、機械が訓練データに含まれる動物を認識するだけでなく、新しい生き物の見た目を教えられれば、その認識にも適応できるようにすることです。data2vecは、同じ自己教師ありアルゴリズムが複数のモダリティでうまく機能することを示しており、しばしば既存の最良のアルゴリズムを上回っています。
これは、より汎用的な自己教師あり学習への道を開き、AIが動画、記事、音声録音を使って、サッカーの仕方やさまざまなパンの焼き方といった複雑なことを学べる世界へと私たちを近づけます。同社は、data2vecによって、コンピュータがタスクを実行するためにラベル付きデータをほとんど必要としない世界が近づくことを期待しています。
注釈付きの例を集めることは困難であり、時には不可能です。例えば数千の言語について音声認識モデルを訓練する場合などです。data2vecは、より汎用的なAIに向けた重要な一歩です。
「人間は視覚、音、言葉を組み合わせて世界を学びます。こうしたシステムも、いつか私たちと同じように世界を理解できるようになるでしょう」
これはまだ研究の初期段階なので、伝説的な「汎用AI」が突然登場することを期待すべきではありません。しかし、さまざまな分野やデータの種類に対応する汎用的な学習構造を持つAIは、今日私たちが使っているばらばらの小さな知能の寄せ集めよりも、優れた洗練された解決策に思えます。


