
باحثو Meta يطورون ذكاءً اصطناعياً يتعلم بالقدر نفسه من الصور والنصوص والكلام
التعلم الذاتي الإشراف، حين تتعلم الآلات بمراقبة البيئة المحيطة مباشرة بدلاً من التدريب الصريح باستخدام الصور والنصوص والصوت ومصادر البيانات الأخرى المُعنونة، أصبح أساساً للعديد من الإنجازات الكبيرة في مجال الذكاء الاصطناعي في الآونة الأخيرة.
لكن بينما يبدو أن البشر يتعلمون بالطريقة نفسها بغض النظر عن كيفية تلقيهم للمعلومات، سواء عبر البصر أو السمع مثلاً، توجد حالياً فروق كبيرة في كيفية تعلم خوارزميات التعلم الذاتي الإشراف من الصور والكلام والنصوص وغيرها من البيانات.
شكّل هذا التفاوت عائقاً كبيراً أمام الانتشار الأوسع لتقدم التعلم الذاتي الإشراف. فالخوارزمية القوية التي طُورت، على سبيل المثال، لفهم الصور لا يمكن تطبيقها مباشرة على طريقة إدخال أخرى، مثل النصوص، لذلك يصعب تطوير عدة طرائق إدخال بالسرعة نفسها.
ولهذا السبب طورت Meta AI خوارزمية data2vec، وهي أول خوارزمية عالية الأداء للتعلم الذاتي الإشراف تعمل على عدة طرائق إدخال. طُبقت data2vec على الكلام والصور والنصوص كل على حدة، وتفوقت على أفضل الخوارزميات السابقة أحادية الغرض في الرؤية الحاسوبية والكلام، وكانت منافسة في مهام معالجة اللغة الطبيعية (NLP).
يمثل هذا نموذجاً جديداً للتعلم الذاتي الإشراف الشامل، حيث تحسّن الأبحاث الجديدة عدة طرائق إدخال، لا طريقة واحدة فقط. كما أنه لا يعتمد على التعلم التقابلي أو على إعادة بناء مثال الإدخال.
لا تساعد data2vec على تسريع التقدم في مجال الذكاء الاصطناعي فحسب، بل تقربنا أيضاً من بناء آلات تتعلم الجوانب المختلفة للعالم المحيط بسلاسة. وسيتيح ذلك تطوير ذكاء اصطناعي أكثر قابلية للتكيف، يرى الباحثون أنه قادر على أداء مهام تتجاوز قدرات الأنظمة الحالية.
كيف يعمل data2vec
ما زال معظم الذكاء الاصطناعي يعتمد على التعلم الخاضع للإشراف، الذي يعمل حصرياً على البيانات المُعنونة. لكن جمع بيانات معنونة عن كل الأشياء التي نريد من الآلات تنفيذها أمر مستحيل ببساطة. فعلى سبيل المثال، رغم أن الباحثين بذلوا جهداً كبيراً في إنشاء مجموعات بيانات معنونة واسعة النطاق للكلام والنصوص الإنجليزية، فإن ذلك غير ممكن لآلاف اللغات المنطوقة في العالم.
يتيح التعلم الذاتي الإشراف للحواسيب أن تتعرف على العالم بمجرد مراقبته، ثم استخلاص بنية الصور أو الكلام أو النصوص. ووجود آلات لا تحتاج إلى تدريب صريح على تصنيف الصور أو فهم اللغة المنطوقة أمر أكثر قابلية للتوسع بكثير.
تتمحور أبحاث التعلم الذاتي الإشراف اليوم تقريباً دائماً حول طريقة إدخال واحدة محددة. ونتيجة لذلك، غالباً ما يتبع الباحثون الذين يعملون على طريقة واحدة نهجاً مختلفاً تماماً عن الذين يعملون على أخرى. أما في النصوص، فيدرّب الباحثون النماذج على ملء الفراغات في الجمل.

أما نماذج الكلام، فيجب أن تتعلم قائمة الأصوات الأساسية للكلام لتتنبأ بالأصوات المفقودة. وفي الرؤية الحاسوبية، تُدرَّب النماذج غالباً على إسناد تمثيلات متشابهة لصورة ملونة لبقرة وللصورة نفسها مقلوبة رأساً على عقب، فتربطهما ببعض أقوى بكثير مما تربط بينهما وبين صورة لا علاقة لها، مثل صورة بطة.
تتنبأ الخوارزميات أيضاً بوحدات قياس مختلفة لكل طريقة إدخال: البكسلات أو الرموز البصرية للصور، والكلمات للنصوص، ومجموعات الأصوات المحفوظة للكلام. فمجموعة البكسلات تختلف كثيراً عن الموجة الصوتية أو مقطع النص، ولذلك يرتبط تطوير الخوارزمية بطريقة إدخال معينة. وهذا يعني أن الخوارزميات ما زالت تعمل بشكل مختلف في كل طريقة إدخال.
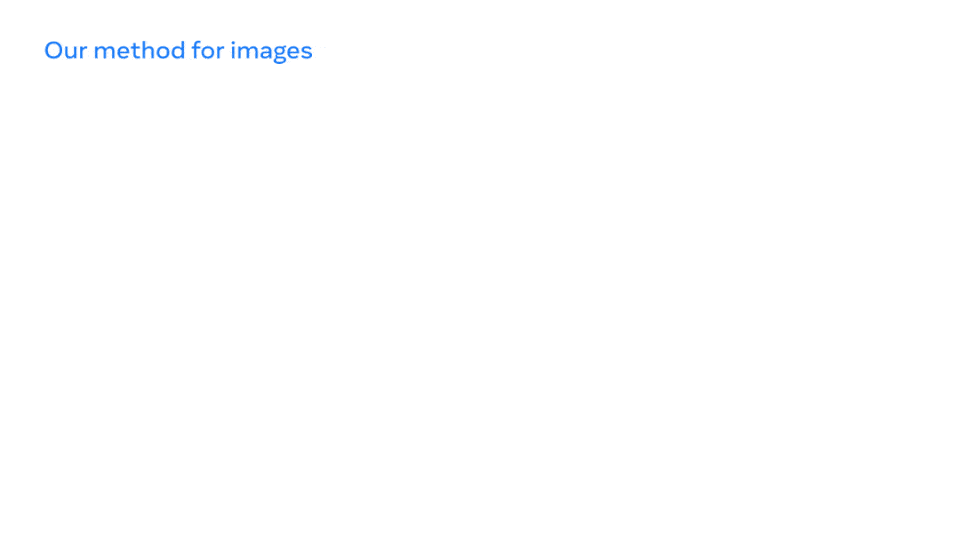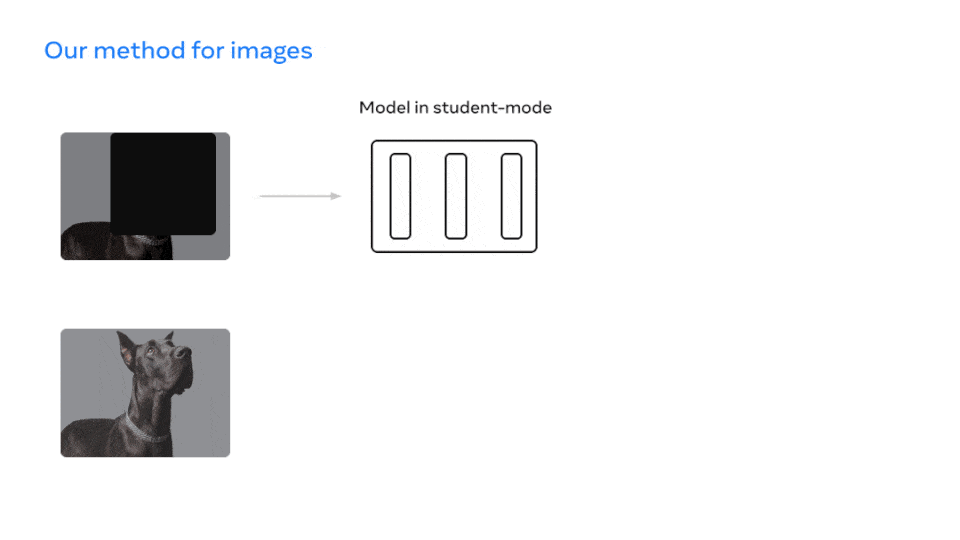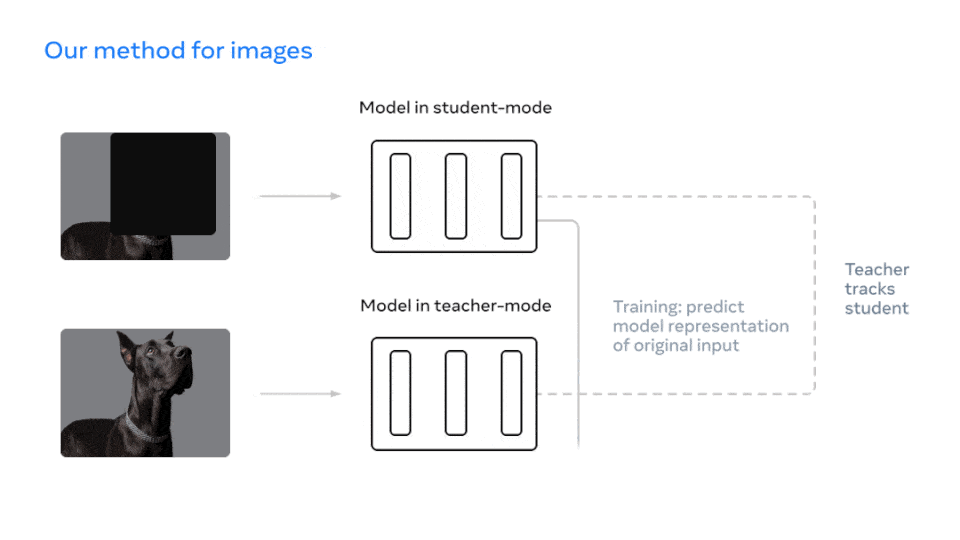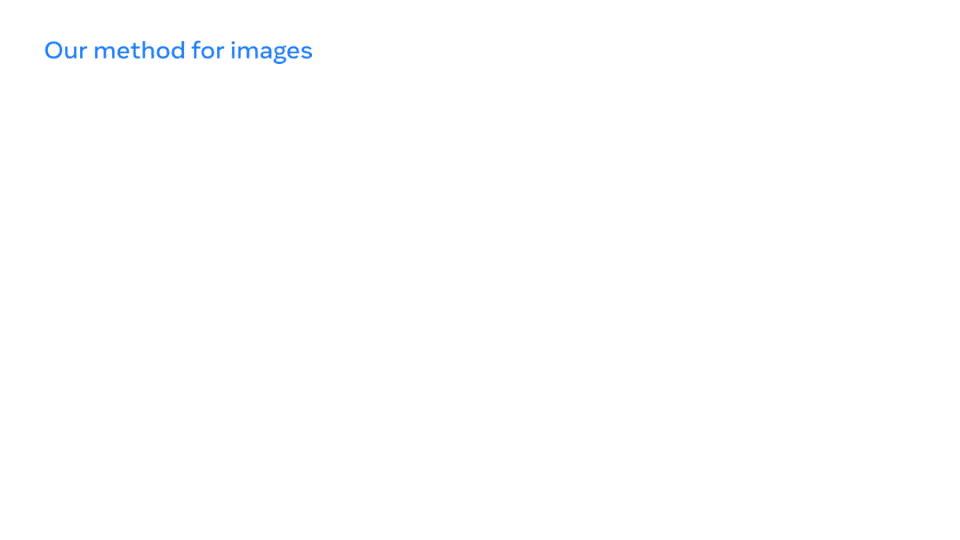
يبسط data2vec هذا الأمر بتدريب النماذج على التنبؤ بتمثيلاتها الخاصة لبيانات الإدخال، بغض النظر عن طريقة الإدخال. فبالتركيز على هذه التمثيلات، وهي طبقات الشبكة العصبية، بدلاً من التنبؤ بالرموز البصرية أو الكلمات أو الأصوات، يستطيع خوارزمية واحدة التعامل مع أنواع مختلفة تماماً من بيانات الإدخال.
يستخدم منهج باحثي Meta شبكة معلِّمة لحساب التمثيلات المستهدفة أولاً من صورة أو مقطع نصي أو عبارة كلامية. ثم يُخفى جزء من بيانات الإدخال، وتتكرر العملية مع شبكة متعلِّمة تتنبأ بالتمثيلات المخفية الصادرة عن الشبكة المعلِّمة. ويجب على نموذج المتعلِّم أن يتنبأ بتمثيل كل بيانات الإدخال، حتى لو كان لديه تمثيل لجزء من المعلومات فقط.
اختبر العلماء هذا المنهج على اختبار الرؤية الحاسوبية الشهير ImageNet، حيث تفوق على الطرائق الموجودة لأحجام النماذج الشائعة. وفي الكلام، وجدوا أنه يعمل بشكل أفضل من wav2vec 2.0 وHuBERT، وهما خوارزميتان سابقتان للتعلم الذاتي الإشراف للكلام من Meta AI. أما في النصوص، فاختبروه على مجموعة الاختبارات الشهيرة GLUE، فأعطى النتائج نفسها التي حققها RoBERTa، وهو إعادة تنفيذ لنموذج BERT.

رغم أن التعلم الذاتي الإشراف حقق نجاحات كبيرة في الرؤية الحاسوبية والفيديو وطرائق إدخال فردية أخرى بأهداف تدريب مختلفة، فإن الفكرة الأساسية لهذا النهج تكمن في تعلم أعم: يجب أن يكون الذكاء الاصطناعي قادراً على تعلم تنفيذ مهام كثيرة ومتنوعة، بما في ذلك مهام غريبة تماماً عنه.
يريد الباحثون أن تتعرف الآلة لا على الحيوانات الواردة في بيانات التدريب فحسب، بل أن تتكيف أيضاً لتتعرف على كائنات جديدة إذا أُخبرت بشكلها. وتُظهر data2vec أن الخوارزمية نفسها للتعلم الذاتي الإشراف يمكن أن تعمل بكفاءة في طرائق إدخال مختلفة، وغالباً بشكل أفضل من أفضل الخوارزميات الحالية.
يمهّد هذا الطريق نحو تعلم ذاتي إشراف أعم، ويقربنا من عالم يستطيع فيه الذكاء الاصطناعي استخدام الفيديوهات والمقالات والتسجيلات الصوتية لتعلم أشياء معقدة، مثل لعب كرة القدم أو طرق مختلفة لخبز الخبز. وتأمل الشركة أن يقربنا data2vec جميعاً من عالم تحتاج فيه الحواسيب إلى قدر ضئيل جداً من البيانات المعنونة لتنفيذ المهام.
ولأن جمع الأمثلة المشروحة أمر صعب، بل ومستحيل أحياناً، مثل تدريب نماذج التعرف على الكلام لآلاف اللغات، يمثل data2vec خطوة مهمة نحو ذكاء اصطناعي أعم.
«يتعلم البشر العالم من خلال مزيج من البصر والصوت والكلمات، وقد تتمكن الأنظمة المشابهة يوماً ما من فهم العالم كما نفهمه نحن»
ما زالت هذه مرحلة مبكرة من الأبحاث، لذا لا تتوقعوا ظهور ما يُسمى «الذكاء الاصطناعي العام» فجأة. لكن وجود ذكاء اصطناعي ببنية تعلم عامة تعمل مع مجالات وأنواع بيانات مختلفة يبدو حلاً أفضل وأكثر أناقة من مجموعة الذكاءات الصغيرة المتفرقة التي نتعامل معها اليوم.


