
Les chercheurs de Meta créent une IA qui apprend aussi bien à partir d'images, de textes et de la parole
L'apprentissage auto-supervisé, où les machines apprennent en observant directement leur environnement plutôt qu'en étant explicitement entraînées avec des images, textes, audios et autres sources de données étiquetées, est à la base de nombreuses avancées récentes de l'IA.
Pourtant, alors que les humains semblent apprendre de la même manière, quelle que soit la façon dont ils reçoivent l'information (par exemple par la vue ou l'ouïe), les algorithmes d'apprentissage auto-supervisé actuels apprennent très différemment à partir d'images, de paroles, de textes et d'autres données.
Cette incohérence a constitué un obstacle majeur à une application plus large des progrès de l'apprentissage auto-supervisé. Un algorithme puissant conçu, par exemple, pour comprendre des images ne peut pas être directement appliqué à une autre modalité, comme le texte, il est donc difficile de faire progresser plusieurs modalités au même rythme.
C'est pourquoi Meta AI a développé data2vec, le premier algorithme auto-supervisé à haute performance fonctionnant sur plusieurs modalités. Data2vec a été appliqué séparément à la parole, aux images et au texte. Il a surpassé les meilleurs algorithmes mono-tâche précédents pour la vision par ordinateur et la parole, et il est compétitif sur les tâches de TAL (traitement automatique du langage naturel).
Il s'agit d'un nouveau paradigme d'apprentissage auto-supervisé unifié, où les nouvelles recherches améliorent plusieurs modalités et non une seule. Il ne repose pas non plus sur l'apprentissage contrastif ni sur la reconstruction de l'exemple d'entrée.
Data2vec ne se contente pas d'accélérer les progrès de l'intelligence artificielle, il nous rapproche aussi de machines capables d'apprendre sans heurts les différents aspects du monde qui nous entoure. Cela permettra de développer une IA plus adaptable, qui, selon les chercheurs, pourra accomplir des tâches dépassant les capacités des systèmes actuels.
Comment fonctionne data2vec
La plupart de l'IA repose encore sur l'apprentissage supervisé, qui fonctionne exclusivement avec des données étiquetées. Mais il est tout simplement impossible de réunir des données étiquetées sur toutes les choses que nous voudrions que les machines accomplissent. Par exemple, même si les chercheurs ont beaucoup travaillé à la création de grands jeux de données étiquetés pour la parole et le texte en anglais, cela est impossible pour littéralement des milliers de langues parlées sur la planète.
L'auto-supervision permet aux ordinateurs d'apprendre sur le monde simplement en l'observant, puis en découvrant la structure des images, de la parole ou du texte. Disposer de machines qu'il n'est pas nécessaire d'entraîner explicitement à classer des images ou à comprendre le langage parlé est bien plus scalable.
Les recherches actuelles sur l'apprentissage auto-supervisé se concentrent presque toujours sur une seule modalité spécifique. Ainsi, les chercheurs travaillant sur une modalité utilisent souvent une approche tout à fait différente de ceux qui travaillent sur une autre. Pour le texte, les chercheurs entraînent des modèles à combler les blancs dans les phrases.

Les modèles de parole, en revanche, doivent apprendre une liste de sons fondamentaux de la parole pour prédire les sons manquants. En vision par ordinateur, les modèles sont souvent entraînés à attribuer des représentations similaires à l'image couleur d'une vache et à cette même image retournée à l'envers, de sorte qu'ils les rapprochent bien plus que d'une image sans rapport, comme celle d'un canard.
Les algorithmes prédisent aussi des unités différentes pour chaque modalité : des pixels ou des jetons visuels pour les images, des mots pour le texte et des ensembles de sons appris pour la parole. Un ensemble de pixels diffère fortement d'une onde sonore ou d'un passage de texte, si bien que la conception d'un algorithme est liée à une modalité donnée. Cela signifie que les algorithmes fonctionnent toujours différemment selon chaque modalité.
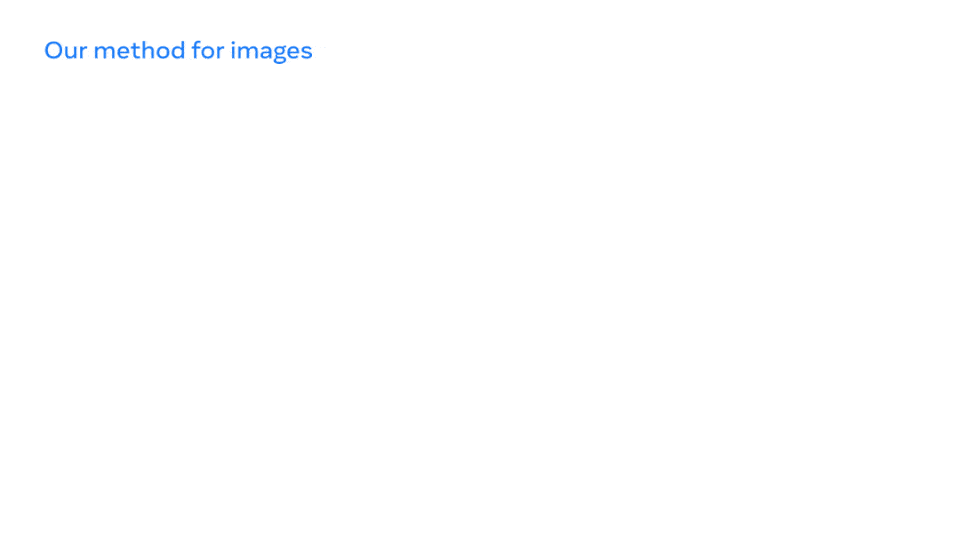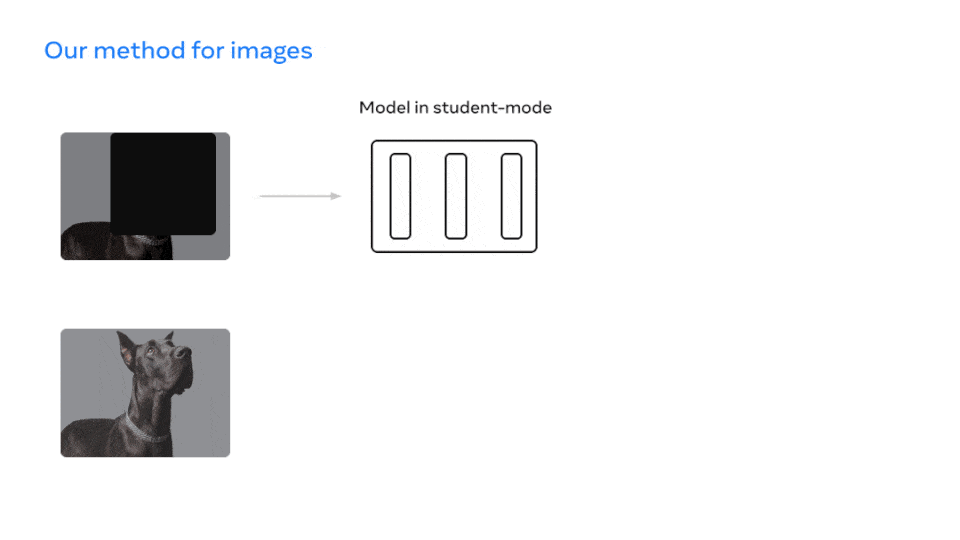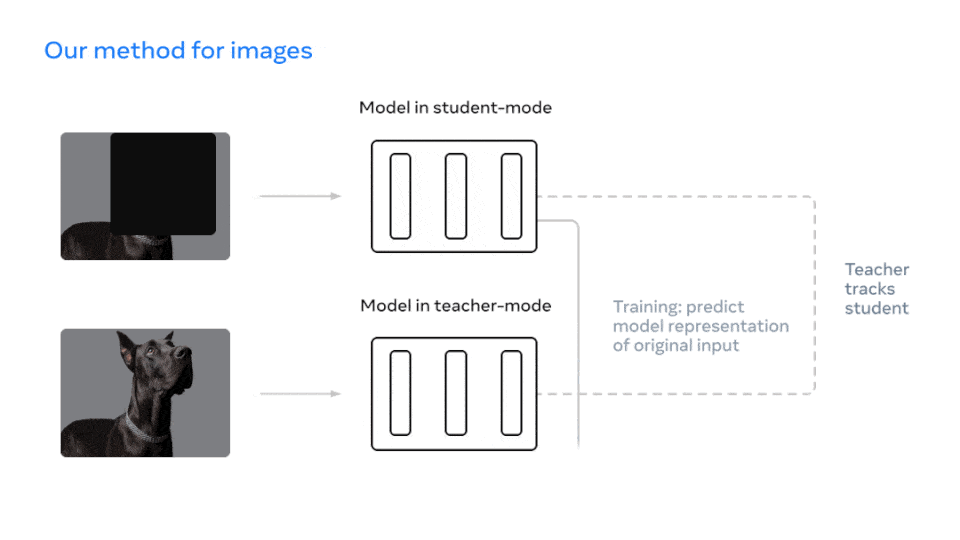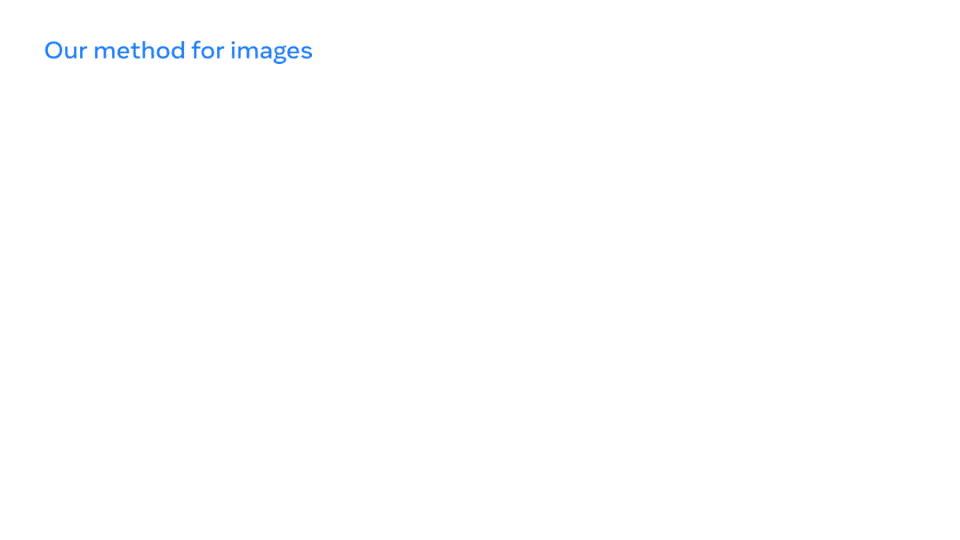
Data2vec simplifie cela en entraînant les modèles à prédire leurs propres représentations des données d'entrée, quelle que soit la modalité. En se concentrant sur ces représentations — les couches du réseau de neurones — plutôt que sur la prédiction de symboles visuels, de mots ou de sons, un seul algorithme peut traiter des types de données d'entrée très différents.
La méthode des chercheurs de Meta utilise d'abord un réseau enseignant pour calculer des représentations cibles à partir d'une image, d'un fragment de texte ou d'un énoncé oral. Ensuite, une partie des données d'entrée est masquée et le processus est répété avec un réseau élève, qui prédit les représentations cachées produites par l'enseignant. Le modèle élève doit prédire la représentation de l'ensemble des données d'entrée, même s'il ne dispose que d'une partie de l'information.
Les scientifiques ont testé cette méthode sur le test populaire de vision par ordinateur ImageNet, où elle a donné de meilleurs résultats que les méthodes existantes pour des tailles de modèles courantes. Pour la parole, ils ont constaté qu'elle surpasse wav2vec 2.0 et HuBERT, deux algorithmes auto-supervisés de Meta AI pour la parole. Pour le texte, ils l'ont testée sur le jeu de tests populaire GLUE, où elle a obtenu les mêmes résultats que RoBERTa, une réimplémentation de BERT.

Si l'apprentissage auto-supervisé a réalisé de grands progrès en vision par ordinateur, en vidéo et dans d'autres modalités individuelles grâce à différents objectifs d'apprentissage, l'idée principale de cette approche est un apprentissage plus général : l'IA doit être capable d'apprendre à accomplir de nombreuses tâches différentes, y compris des tâches totalement inconnues.
Les chercheurs veulent qu'une machine ne se contente pas de reconnaître les animaux présents dans ses données d'entraînement, mais qu'elle s'adapte pour reconnaître de nouvelles créatures si on lui explique à quoi elles ressemblent. Data2vec montre qu'un même algorithme auto-supervisé peut bien fonctionner sur différentes modalités, et souvent mieux que les meilleurs algorithmes existants.
Cela ouvre la voie à un apprentissage auto-supervisé plus général et nous rapproche d'un monde où l'IA pourra utiliser des vidéos, des articles et des enregistrements audio pour apprendre des choses complexes, comme jouer au football ou les différentes façons de faire du pain. L'entreprise espère que data2vec nous rapprochera tous d'un monde où les ordinateurs n'ont besoin que de très peu de données étiquetées pour accomplir des tâches.
Comme il est difficile, voire impossible parfois, de réunir des exemples annotés — par exemple pour entraîner des modèles de reconnaissance vocale dans des milliers de langues — data2vec constitue une étape importante vers une IA plus générale.
« Les humains découvrent le monde grâce à une combinaison de vision, de son et de mots, et des systèmes similaires pourront un jour comprendre le monde comme nous le faisons »
Il s'agit encore d'un stade précoce de la recherche, il ne faut donc pas s'attendre à voir apparaître soudainement la légendaire « IA générale » — mais une IA dotée d'une structure d'apprentissage généralisée, capable de fonctionner avec différents domaines et types de données, semble une solution meilleure et plus élégante que l'ensemble disparate de micro-intelligences avec lequel nous nous débrouillons aujourd'hui.


