
Дослідники Meta створюють ШІ, який однаково добре навчається на візуальних, письмових і усних матеріалах
Самоконтрольоване навчання — коли машини вчаться, безпосередньо спостерігаючи за навколишнім середовищем, а не навчаючись явно за допомогою позначених зображень, тексту, аудіо та інших джерел даних — стало основою для багатьох значних останніх досягнень у сфері ШІ.
Але в той час як люди, імовірно, вчаться однаково, незалежно від того, як вони отримують інформацію — використовують вони, наприклад, зір чи слух — наразі існують великі відмінності в тому, як алгоритми навчання з самоконтролем вчаться на основі зображень, мовлення, тексту та інших даних.
Ця невідповідність була серйозною перешкодою для ширшого застосування досягнень у навчанні з самоконтролем. Оскільки потужний алгоритм, розроблений, скажімо, для розуміння зображень, не можна напряму застосувати до іншої модальності, наприклад до тексту, важко просувати вперед кілька модальностей з однаковою швидкістю.
Саме тому компанія Meta AI розробила data2vec — перший високопродуктивний алгоритм з самоконтролем, який працює для кількох модальностей. Data2vec застосували окремо до мовлення, зображень і тексту, і він перевершив попередні найкращі одноцільові алгоритми для комп'ютерного зору та мовлення, а також конкурентоспроможний у завданнях NLP (обробка природної мови).
Це становить собою нову парадигму цілісного самоконтрольованого навчання, де нові дослідження покращують кілька модальностей, а не лише одну. Вона також не покладається на контрастивне навчання чи реконструкцію вхідного прикладу.
Data2vec не лише допомагає прискорити прогрес у сфері штучного інтелекту, а й наближає нас до створення машин, які безперешкодно вивчають різні аспекти навколишнього світу. Це дозволить розробити адаптивніший ШІ, який, за словами дослідників, зможе виконувати завдання, що виходять за межі можливостей сучасних систем.
Як працює data2vec
Значна частина ШІ досі базується на контрольованому навчанні, яке працює виключно з розміченими даними. Але просто неможливо зібрати розмічені дані про всі ті речі, які ми хотіли б, щоб машини виконували. Наприклад, попри те що дослідники виконали велику роботу зі створення масштабних розмічених наборів даних для англійського мовлення і тексту, це неможливо зробити для буквально тисяч мов, якими говорять на планеті.
Самоконтроль дозволяє комп'ютерам пізнавати світ, просто спостерігаючи за ним, а потім з'ясовуючи структуру зображень, мовлення чи тексту. Наявність машин, яких не потрібно явно навчати класифікувати зображення або розуміти розмовну мову, значно масштабованіша.
Сьогоднішні дослідження в галузі навчання з самоконтролем майже завжди зосереджені на одній конкретній модальності. Таким чином, дослідники, які працюють з однією модальністю, часто використовують зовсім інший підхід, ніж ті, хто працює з іншою. Що стосується тексту, дослідники навчають моделі заповнювати пропуски в реченнях.

Мовленнєві моделі, however, повинні вивчити список основних звуків мовлення, щоб передбачити пропущені звуки. У комп'ютерному зорі моделі часто навчаються призначати схожі представлення кольоровому зображенню корови і тому самому зображенню, перевернутому догори ногами, тож вони пов'язують їх набагато тісніше, ніж з непов'язаним зображенням, таким як зображення качки.
Алгоритми також передбачають різні одиниці вимірювання для кожної модальності: пікселі або візуальні маркери для зображень, слова для тексту та вивчені набори звуків для мовлення. Набір пікселів значно відрізняється від звукової хвилі чи уривка тексту, тому розробка алгоритму прив'язана до конкретної модальності. Це означає, що алгоритми досі працюють по-різному в кожній модальності.
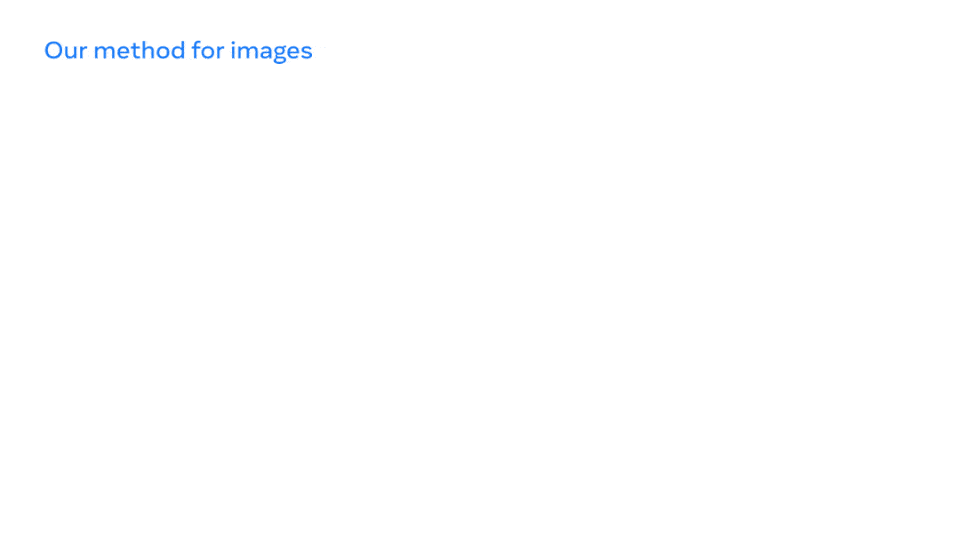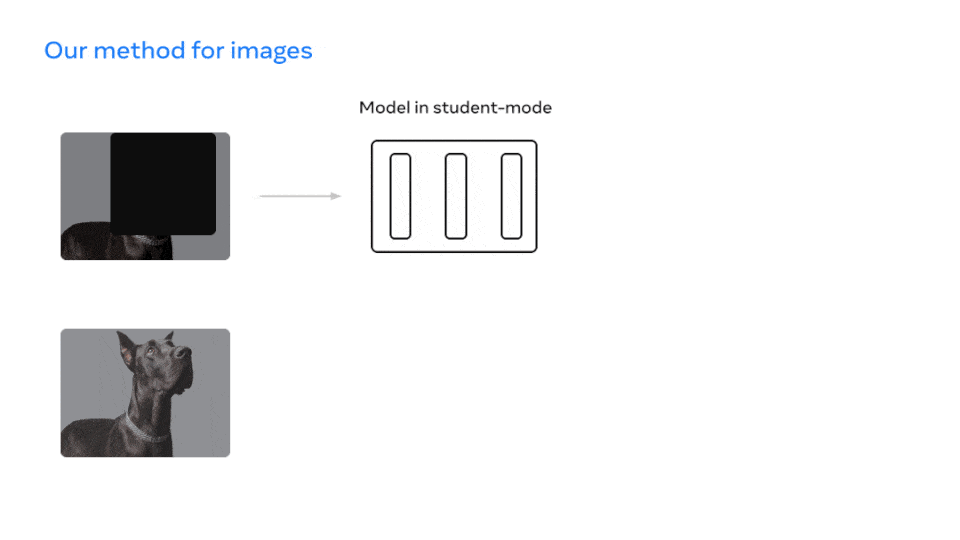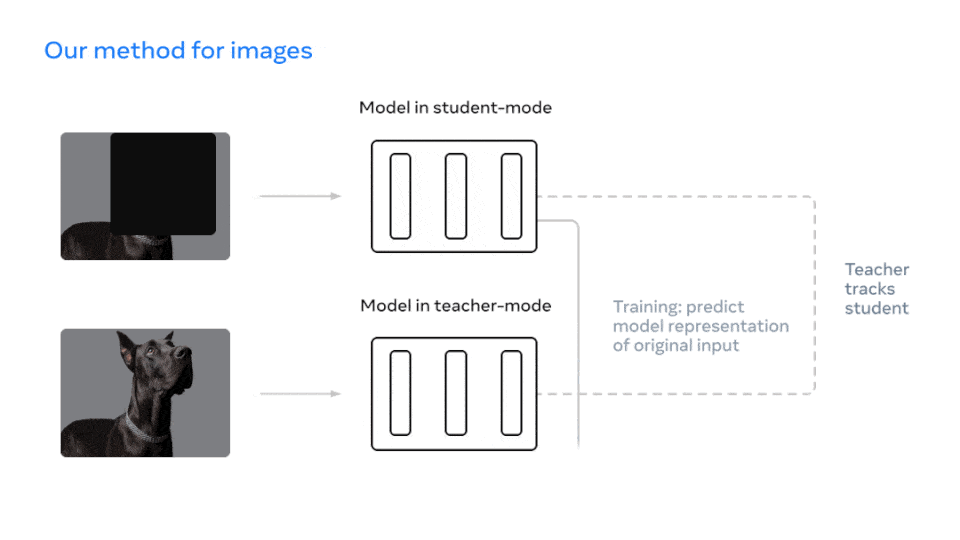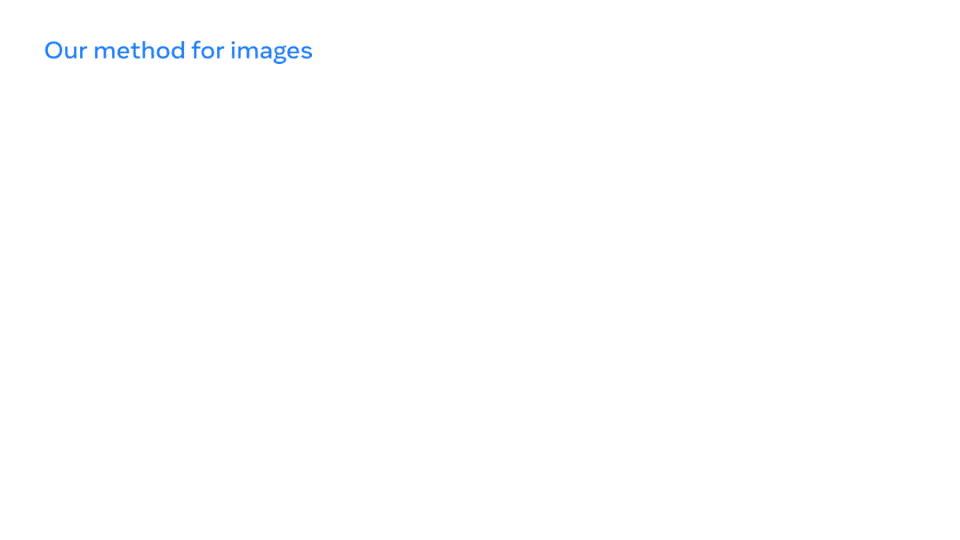
Data2vec спрощує це, навчаючи моделі передбачати їхні власні представлення вхідних даних, незалежно від модальності. Зосереджуючись на цих представленнях — шарах нейронної мережі — а не на передбаченні візуальних символів, слів чи звуків, один алгоритм може працювати з абсолютно різними типами вхідних даних.
Метод дослідників Meta використовує мережу-вчителя, щоб спочатку обчислити цільові представлення із зображення, фрагмента тексту або мовленнєвого висловлювання. Потім частина вхідних даних маскується і процес повторюється з мережею-учнем, яка потім передбачає приховані представлення мережі-вчителя. Модель-учень повинна передбачити представлення всіх вхідних даних, навіть якщо вона має уявлення лише про частину інформації.
Вчені протестували цей метод на популярному тесті комп'ютерного зору ImageNet, де він працював краще, ніж існуючі методи для популярних розмірів моделей. Щодо мовлення вони виявили, що він працює краще, ніж wav2vec 2.0 або HuBERT — два попередні алгоритми Meta AI з самоконтролем для мовлення. Для тексту їх протестували на популярному наборі тестів GLUE, і він показав такі самі результати, як і RoBERTa — повторна реалізація BERT.

Хоча навчання з самоконтролем досягло великих успіхів у комп'ютерному зорі, відео та інших окремих модальностях за допомогою різних цілей навчання, основна ідея цього підходу полягає в загальнішому навчанні: ШІ має бути здатним навчитися виконувати безліч різних завдань, зокрема абсолютно незнайомих.
Дослідники хочуть, щоб машина не лише розпізнавала тварин, показаних у тренувальних даних, а й адаптувалася до розпізнавання нових істот, якщо їй скажуть, як вони виглядають. Data2vec демонструє, що один і той самий алгоритм з самоконтролем може добре працювати в різних модальностях — і часто краще, ніж найкращі існуючі алгоритми.
Це прокладає шлях до загальнішого самоконтрольованого навчання і наближає нас до світу, в якому ШІ може використовувати відео, статті та аудіозаписи для вивчення складних речей, таких як гра у футбол або різні способи випікання хліба. У компанії сподіваються, що data2vec наблизить нас усіх до світу, в якому комп'ютерам потрібно дуже мало розмічених даних для виконання завдань.
Оскільки складно, а іноді й неможливо збирати анотовані приклади — наприклад, для навчання моделей розпізнавання мовлення для тисяч мов — data2vec є важливим кроком до загальнішого ШІ.
«Люди пізнають світ за допомогою поєднання зору, звуку і слів, і подібні системи колись зможуть зрозуміти світ так само, як ми»
Це все ще рання стадія досліджень, тож не очікуйте, що легендарний «загальний ШІ» з'явиться раптово — але наявність ШІ з узагальненою структурою навчання, яка працює з різними предметними областями і типами даних, здається кращим і елегантнішим рішенням, ніж той розрізнений набір мікророзумів, з яким ми сьогодні обходимось.


