
Investigadores de Meta crean una IA que aprende igual de bien a partir de imágenes, textos y voz
El aprendizaje autosupervisado, en el que las máquinas aprenden observando directamente su entorno en lugar de recibir instrucciones explícitas mediante imágenes, textos, audios y otras fuentes de datos etiquetados, se ha convertido en la base de muchos avances recientes importantes en IA.
Sin embargo, aunque las personas parecen aprender de la misma manera independientemente de cómo reciban la información, por ejemplo, usando la vista o el oído, actualmente existen grandes diferencias en la forma en que los algoritmos de aprendizaje autosupervisado aprenden a partir de imágenes, habla, texto y otros datos.
Esta discrepancia ha sido un obstáculo importante para la aplicación más amplia de los avances en el aprendizaje autosupervisado. Como un algoritmo potente diseñado, por ejemplo, para comprender imágenes no puede aplicarse directamente a otra modalidad, como el texto, resulta difícil avanzar en varias modalidades a la vez.
Precisamente por eso Meta AI desarrolló data2vec, el primer algoritmo autosupervisado de alto rendimiento que funciona con varias modalidades. Data2vec se aplicó por separado al habla, las imágenes y el texto, y superó a los mejores algoritmos anteriores de un solo propósito para visión artificial y voz, además de ser competitivo en tareas de PLN (procesamiento del lenguaje natural).
Esto representa un nuevo paradigma de aprendizaje autosupervisado integral, en el que las nuevas investigaciones mejoran varias modalidades y no solo una. Además, no depende del aprendizaje contrastivo ni de la reconstrucción de la entrada de ejemplo.
Data2vec no solo ayuda a acelerar el progreso en el campo de la inteligencia artificial, sino que también nos acerca a la creación de máquinas que aprenden de forma fluida distintos aspectos del mundo que nos rodea. Esto permitirá desarrollar una IA más adaptable que, según creen los investigadores, podrá realizar tareas que van más allá de las capacidades de los sistemas actuales.
Cómo funciona data2vec
Gran parte de la IA sigue basándose en el aprendizaje supervisado, que trabaja exclusivamente con datos etiquetados. Pero es sencillamente imposible reunir datos etiquetados sobre todas las cosas que queremos que las máquinas hagan. Por ejemplo, aunque los investigadores han hecho un gran trabajo creando conjuntos de datos etiquetados a gran escala para el inglés hablado y escrito, eso no es posible para literalmente miles de lenguas que se hablan en el planeta.
El autoaprendizaje permite a los ordenadores conocer el mundo simplemente observándolo y, después, descubrir la estructura de las imágenes, el habla o el texto. Disponer de máquinas que no necesitan que se les enseñe explícitamente a clasificar imágenes o a entender el lenguaje hablado es mucho más escalable.
La investigación actual en aprendizaje autosupervisado casi siempre se centra en una única modalidad. Por ello, los investigadores que trabajan en una modalidad suelen usar un enfoque completamente distinto al de quienes trabajan en otra. En el caso del texto, los investigadores entrenan modelos para rellenar huecos en las frases.

Los modelos de voz, en cambio, deben aprender una lista de sonidos básicos del habla para predecir los sonidos que faltan. En visión artificial, los modelos suelen entrenarse para asignar representaciones similares a una imagen en color de una vaca y a la misma imagen boca abajo, de modo que las vinculan mucho más estrechamente que a una imagen no relacionada, como la de un pato.
Los algoritmos también predicen unidades de medida distintas para cada modalidad: píxeles o tokens visuales para las imágenes, palabras para el texto y conjuntos aprendidos de sonidos para el habla. Un conjunto de píxeles es muy diferente de una onda sonora o de un fragmento de texto, por lo que el desarrollo de un algoritmo queda ligado a una modalidad concreta. Esto significa que los algoritmos siguen funcionando de forma distinta en cada modalidad.
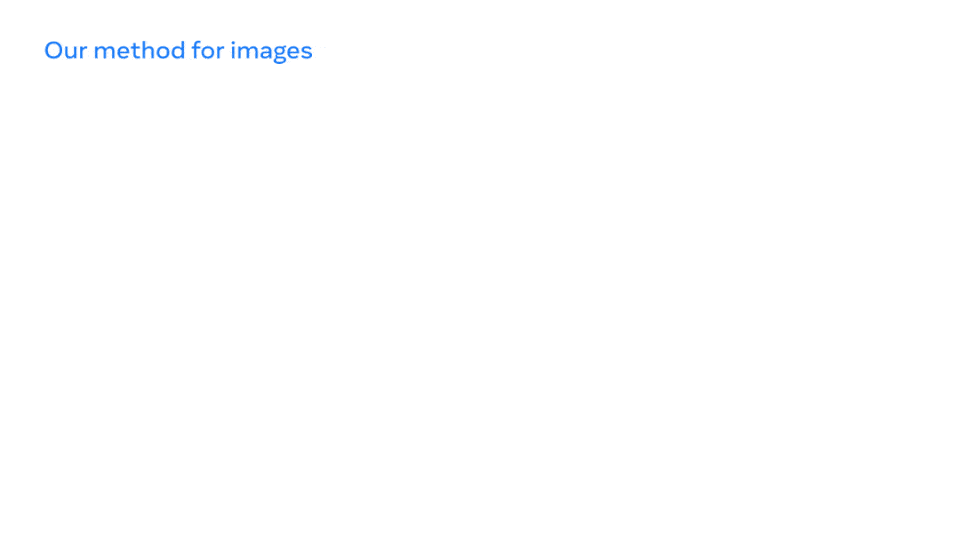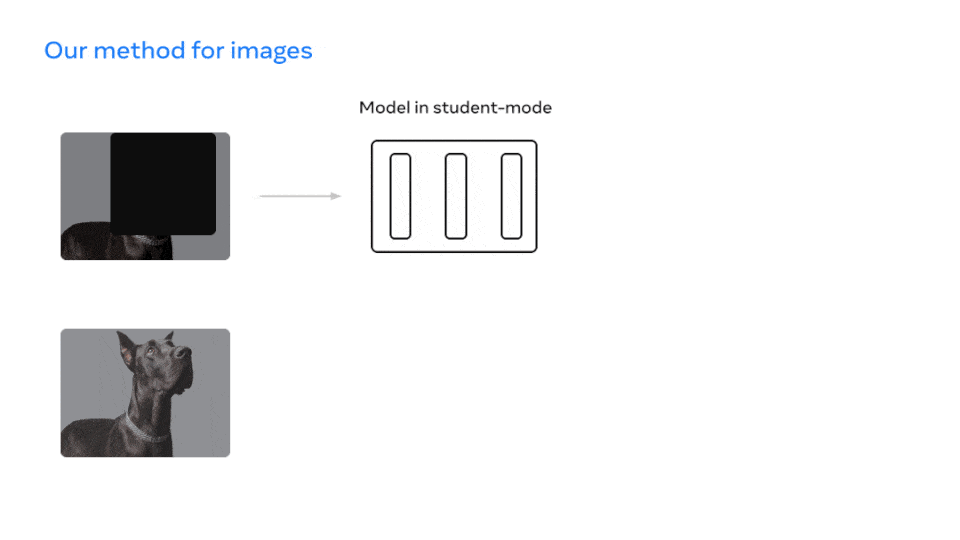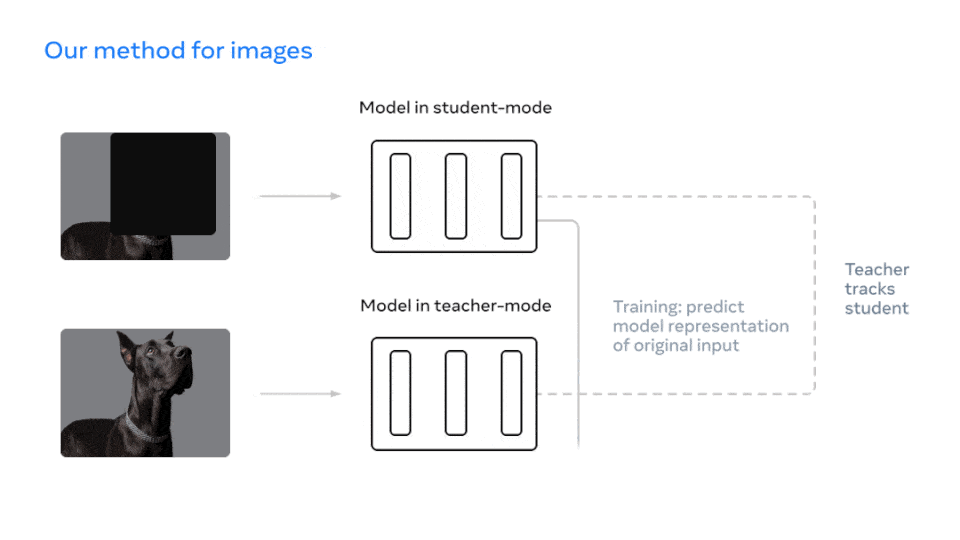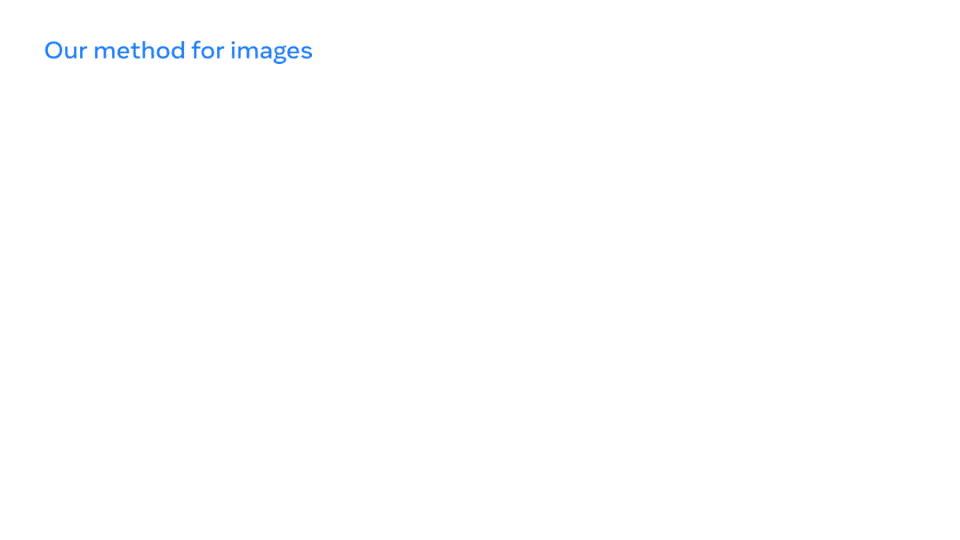
Data2vec simplifica esto entrenando modelos para predecir sus propias representaciones de los datos de entrada, independientemente de la modalidad. Al centrarse en estas representaciones, es decir, en las capas de la red neuronal, en lugar de predecir símbolos visuales, palabras o sonidos, un único algoritmo puede trabajar con tipos de entrada muy distintos.
El método de los investigadores de Meta utiliza una red de profesor para calcular primero las representaciones objetivo a partir de una imagen, un fragmento de texto o una expresión hablada. Después, se enmascara parte de los datos de entrada y el proceso se repite con una red de estudiante, que predice las representaciones ocultas del profesor. El modelo del estudiante debe predecir la representación de todos los datos de entrada, aunque solo tenga información sobre una parte de ellos.
Los científicos probaron este método con la popular prueba de visión artificial ImageNet, donde funcionó mejor que los métodos existentes para tamaños de modelo populares. En cuanto a la voz, descubrieron que funciona mejor que wav2vec 2.0 o HuBERT, dos algoritmos anteriores de Meta AI con autoaprendizaje para el habla. En el caso del texto, lo probaron con el conjunto de pruebas GLUE popular y obtuvo los mismos resultados que RoBERTa, una reimplementación de BERT.

Aunque el aprendizaje autosupervisado ha logrado grandes avances en visión artificial, vídeo y otras modalidades individuales mediante diversos objetivos de aprendizaje, la idea principal de este enfoque es un aprendizaje más general: la IA debe ser capaz de aprender a realizar muchas tareas distintas, incluidas las completamente desconocidas.
Los investigadores quieren que una máquina no solo reconozca los animales que aparecen en los datos de entrenamiento, sino que también aprenda a reconocer nuevas criaturas si se le indica cómo son. Data2vec demuestra que un mismo algoritmo autosupervisado puede funcionar bien en distintas modalidades, y a menudo mejor que los mejores algoritmos existentes.
Esto allana el camino hacia un aprendizaje autosupervisado más general y nos acerca a un mundo en el que la IA puede usar vídeos, artículos y grabaciones de audio para aprender cosas complejas, como jugar al fútbol o las distintas formas de hornear pan. En la compañía esperan que data2vec nos acerque a todos a un mundo en el que los ordenadores necesiten muy pocos datos etiquetados para realizar tareas.
Como reunir ejemplos anotados es difícil y, a veces, imposible, por ejemplo, para entrenar modelos de reconocimiento de voz para miles de lenguas, data2vec es un paso importante hacia una IA más general.
«Las personas conocemos el mundo mediante una combinación de vista, sonido y palabras, y sistemas similares algún día podrán entenderlo como nosotros»
Esta todavía es una etapa temprana de la investigación, así que no esperes que la legendaria «IA general» aparezca de repente, pero disponer de una IA con una estructura de aprendizaje generalizada que funcione con distintos ámbitos y tipos de datos parece una solución mejor y más elegante que el conjunto fragmentado de microinteligencias con el que nos apañamos hoy.


