
Исследователи Meta создают ИИ, который одинаково хорошо учится на визуальных, письменных и устных материалах
Самоконтролируемое обучение — когда машины учатся, непосредственно наблюдая за окружающей средой, а не обучаясь явно с помощью помеченных изображений, текста, аудио и других источников данных — стало основой для многих значительных недавних достижений в области ИИ.
Но в то время как люди, по-видимому, учатся одинаковым образом, независимо от того, как они получают информацию — используют ли они, например, зрение или слух — в настоящее время существуют большие различия в том, как алгоритмы обучения с самоконтролем учатся на основе изображений, речи, текста и других данных.
Это несоответствие было серьезным препятствием для более широкого применения достижений в обучении с самоконтролем. Поскольку мощный алгоритм, разработанный, скажем, для понимания изображений, нельзя напрямую применить к другой модальности, например к тексту, трудно продвигать вперед несколько модальностей с одинаковой скоростью.
Именно поэтому компания Meta AI разработала data2vec — первый высокопроизводительный алгоритм с самоконтролем, который работает для нескольких модальностей. Data2vec применяли отдельно к речи, изображениям и тексту, и он превзошел предыдущие лучшие одноцелевые алгоритмы для компьютерного зрения и речи, а также конкурентоспособен в задачах NLP (обработка естественного языка).
Это представляет собой новую парадигму целостного самоконтролируемого обучения, где новые исследования улучшают несколько модальностей, а не только одну. Оно также не полагается на сопоставительное обучение или реконструкцию входного примера.
Data2vec не только помогает ускорить прогресс в области искусственного интеллекта, но и приближает нас к созданию машин, которые беспрепятственно изучают различные аспекты окружающего мира. Это позволит разработать более адаптируемый ИИ, который, как считают исследователи, сможет выполнять задачи, выходящие за рамки возможностей современных систем.
Как работает data2vec
Большая часть ИИ по-прежнему основана на контролируемом обучении, которое работает исключительно с размеченными данными. Но просто невозможно собрать размеченные данные обо всех тех вещах, которые мы хотели бы, чтобы машины выполняли. Например, несмотря на то, что исследователи проделали большую работу по созданию крупномасштабных размеченных наборов данных для английской речи и текста, это невозможно сделать для буквально тысяч языков, на которых говорят на планете.
Самоконтроль позволяет компьютерам узнавать о мире, просто наблюдая за ним, а затем выясняя структуру изображений, речи или текста. Наличие машин, которые не нужно явно учить классифицировать изображения или понимать разговорный язык, гораздо более масштабируемо.
Сегодняшние исследования в области обучения с самоконтролем почти всегда сосредоточены на одной конкретной модальности. Таким образом, исследователи, работающие над одной модальностью, часто используют совершенно иной подход, чем те, кто работает над другой. Что касается текста, исследователи обучают моделей заполнять пробелы в предложениях.

Речевые модели, однако, должны изучить список основных звуков речи, чтобы предсказать пропущенные звуки. В компьютерном зрении модели часто обучаются назначать аналогичные представления цветному изображению коровы и тому же изображению, перевернутому вверх ногами, поэтому оно связывает их гораздо теснее, чем с несвязанным изображением, таким как изображение утки.
Алгоритмы также предсказывают разные единицы измерения для каждой модальности: пиксели или визуальные маркеры для изображений, слова для текста и заученные наборы звуков для речи. Набор пикселей сильно отличается от звуковой волны или отрывка текста, поэтому разработка алгоритма привязана к определенной модальности. Это означает, что алгоритмы по-прежнему работают по-разному в каждой модальности.
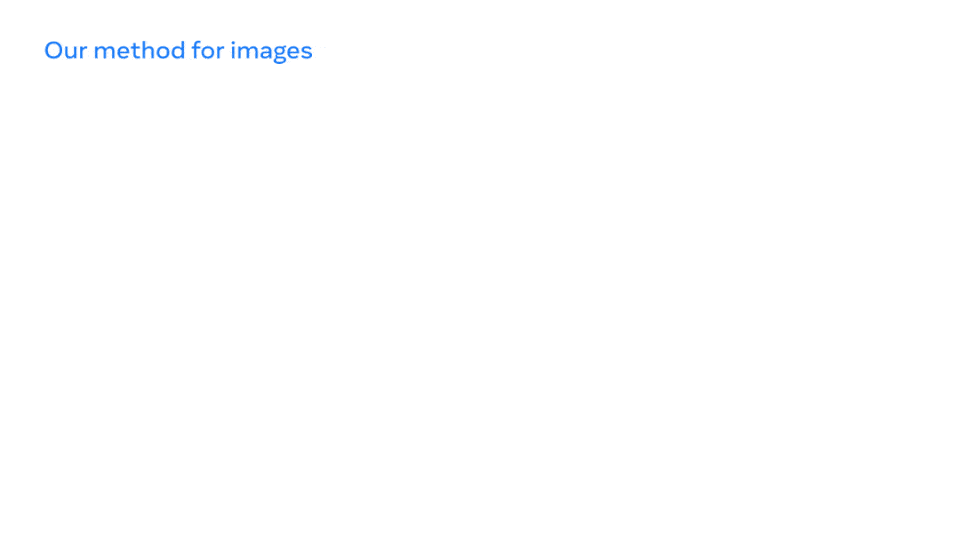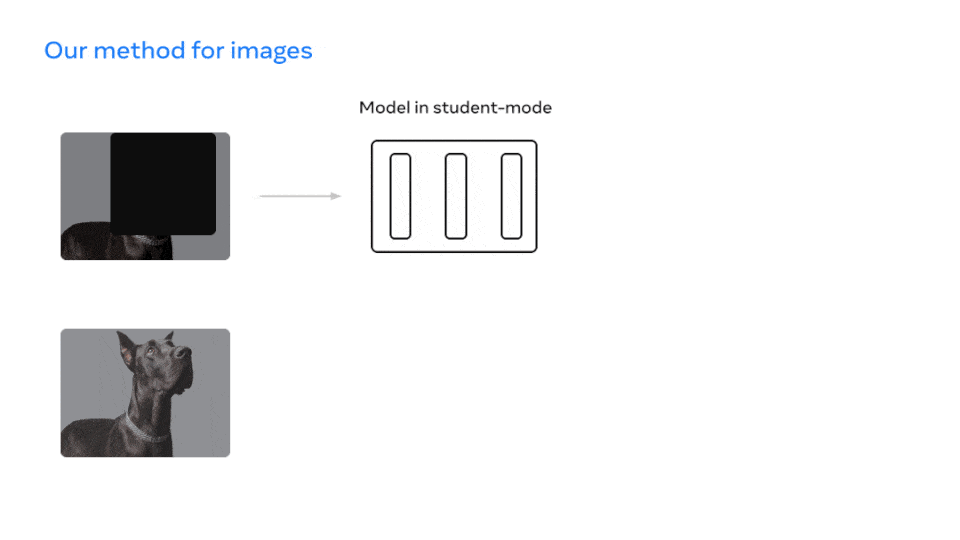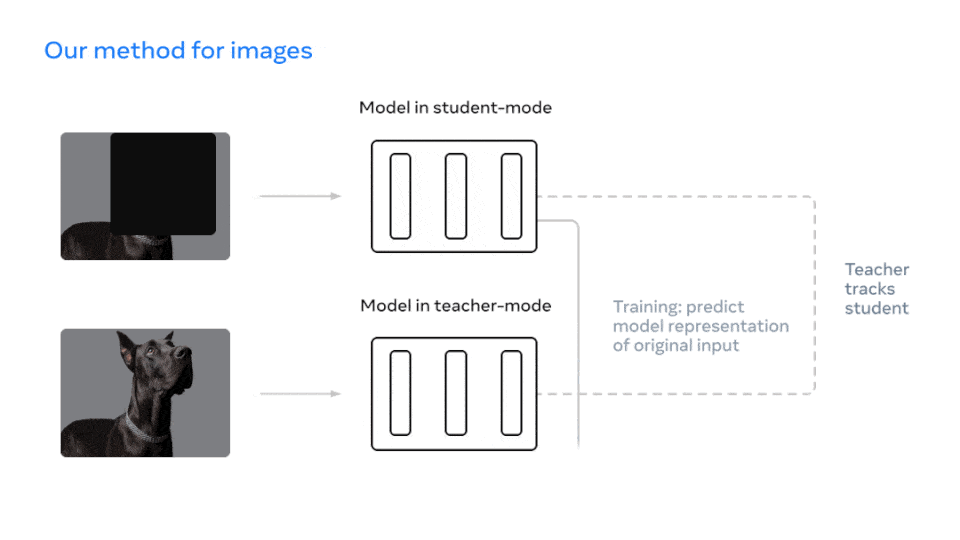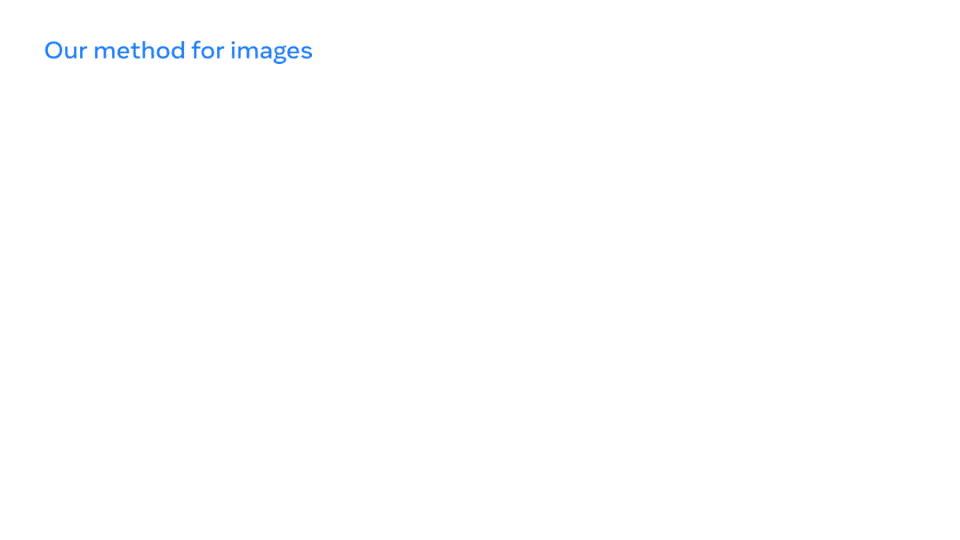
Data2vec упрощает это, обучая модели прогнозировать их собственные представления входных данных, независимо от модальности. Сосредоточившись на этих представлениях — слоях нейронной сети — вместо того, чтобы предсказывать визуальные символы, слова или звуки, один алгоритм может работать с совершенно разными типами входных данных.
Метод исследователей Meta использует учительскую сеть, чтобы сначала вычислить целевые представления из изображения, фрагмента текста или речевого высказывания. Затем маскируется часть входных данных и повторяется процесс со студенческой сетью, которая затем предсказывает скрытые представления учительской. Модель ученика должна предсказать представление всех входных данных, даже если она имеет представление только о части информации.
Ученые протестировали этот метод на популярном тесте компьютерного зрения ImageNet, где он работал лучше, чем существующие методы для популярных размеров моделей. В отношении речи они обнаружили, что он работает лучше, чем wav2vec 2.0 или HuBERT — два предыдущих алгоритма Meta AI с самоконтролем для речи. Для текста они протестировали его на популярном наборе тестов GLUE, и он показал такие же результаты, как и RoBERTa — повторная реализация BERT.

В то время как обучение с самоконтролем добилось больших успехов в компьютерном зрении, видео и других индивидуальных модальностях с помощью различных целей обучения, основная идея этого подхода заключается в более общем обучении: ИИ должен быть в состоянии научиться выполнять множество различных задач, в том числе совершенно незнакомых.
Исследователи хотят, чтобы машина не только распознавала животных, показанных в тренировочных данных, но и адаптировалась к распознаванию новых существ, если ей скажут, как они выглядят. Data2vec демонстрирует, что один и тот же алгоритм с самоконтролем может хорошо работать в разных модальностях — и часто лучше, чем лучшие существующие алгоритмы.
Это прокладывает путь к более общему самоконтролируемому обучению и приближает нас к миру, в котором ИИ может использовать видео, статьи и аудиозаписи для изучения сложных вещей, таких как игра в футбол или различные способы выпечки хлеба. В компании надеются, что data2vec приблизит нас всех к миру, в котором компьютерам требуется очень мало размеченных данных для выполнения задач.
Поскольку сложно, а иногда и невозможно собирать аннотированные примеры — например, для обучения моделей распознавания речи для тысяч языков — data2vec — важный шаг к более общему ИИ.
«Люди познают мир с помощью комбинации зрения, звука и слов, и подобные системы однажды смогут понять мир так же, как мы»
Это все еще ранняя стадия исследований, поэтому не ждите, что легендарный «общий ИИ» появится внезапно — но наличие ИИ с обобщенной структурой обучения, которая работает с различными предметными областями и типами данных, кажется лучшим и более элегантным решением, чем тот разрозненный набор микроразумов, с которым мы сегодня обходимся.


